Yönetici Özeti ve Pazar Konumlandırma
Nvidia’nın Oracle Cloud Infrastructure (OCI) Supercluster'lar içindeki Vera CPU'larının genel erişilebilirlik duyurusu, kurumsal sunucu mimarisinde bir dönüm noktasına işaret ediyor. Nscale, CoreWeave ve Nebius gibi neo-bulutlar büyük ölçüde GPU odaklı dağıtımlara yönelirken, Oracle'ın bağımsız Vera örneklerini stratejik olarak entegre etmesi derin bir değişim sinyali veriyor. Bu, Nvidia'nın bağımsız, hızlandırılmamış bir CPU'yu doğrudan hiper-ölçekli (hyperscale) veri merkezi ana akımına taşımadaki ilk hamlesidir ve Intel ile AMD'nin hakimiyetindeki kökleşmiş x86 hegemonyasıyla kafa kafaya bir çarpışmanın zeminini hazırlamaktadır.
Tarihsel olarak Nvidia'nın veri merkezi bilişim stratejisi, tescilli CPU'larını endüstri lideri GPU'larıyla sıkı bir şekilde birleştirmiştir. Bununla birlikte, Vera'nın Oracle gibi üst düzey bir hiper-ölçek sağlayıcıda bağımsız olarak sunulması bu kalıbı kırmaktadır. Bu durum mimariyi yalnızca Rubin veya Blackwell dizileri için ikincil bir ana bilgisayar işlemcisi olarak değil, kendi başına geçerli genel amaçlı bir bilişim düğümü olarak konumlandırmaktadır. AMD’nin 256 çekirdekli EPYC Venice gibi yaklaşan rakipleri ham tek soketli iş parçacığı yoğunluğunu hedeflese de, Nvidia'nın Vera ile yaptığı hesaplı kumar, topolojiye ve bellek alt sistemi verimliliğine öncelik vermektedir. Bu stratejik farklılaşma, yüksek eşzamanlılıklı, veri yoğun iş yükleri için hızla genişleyen pazarı yakalamayı amaçlamaktadır.
Temel Mimari ve Teknolojik Yenilikler
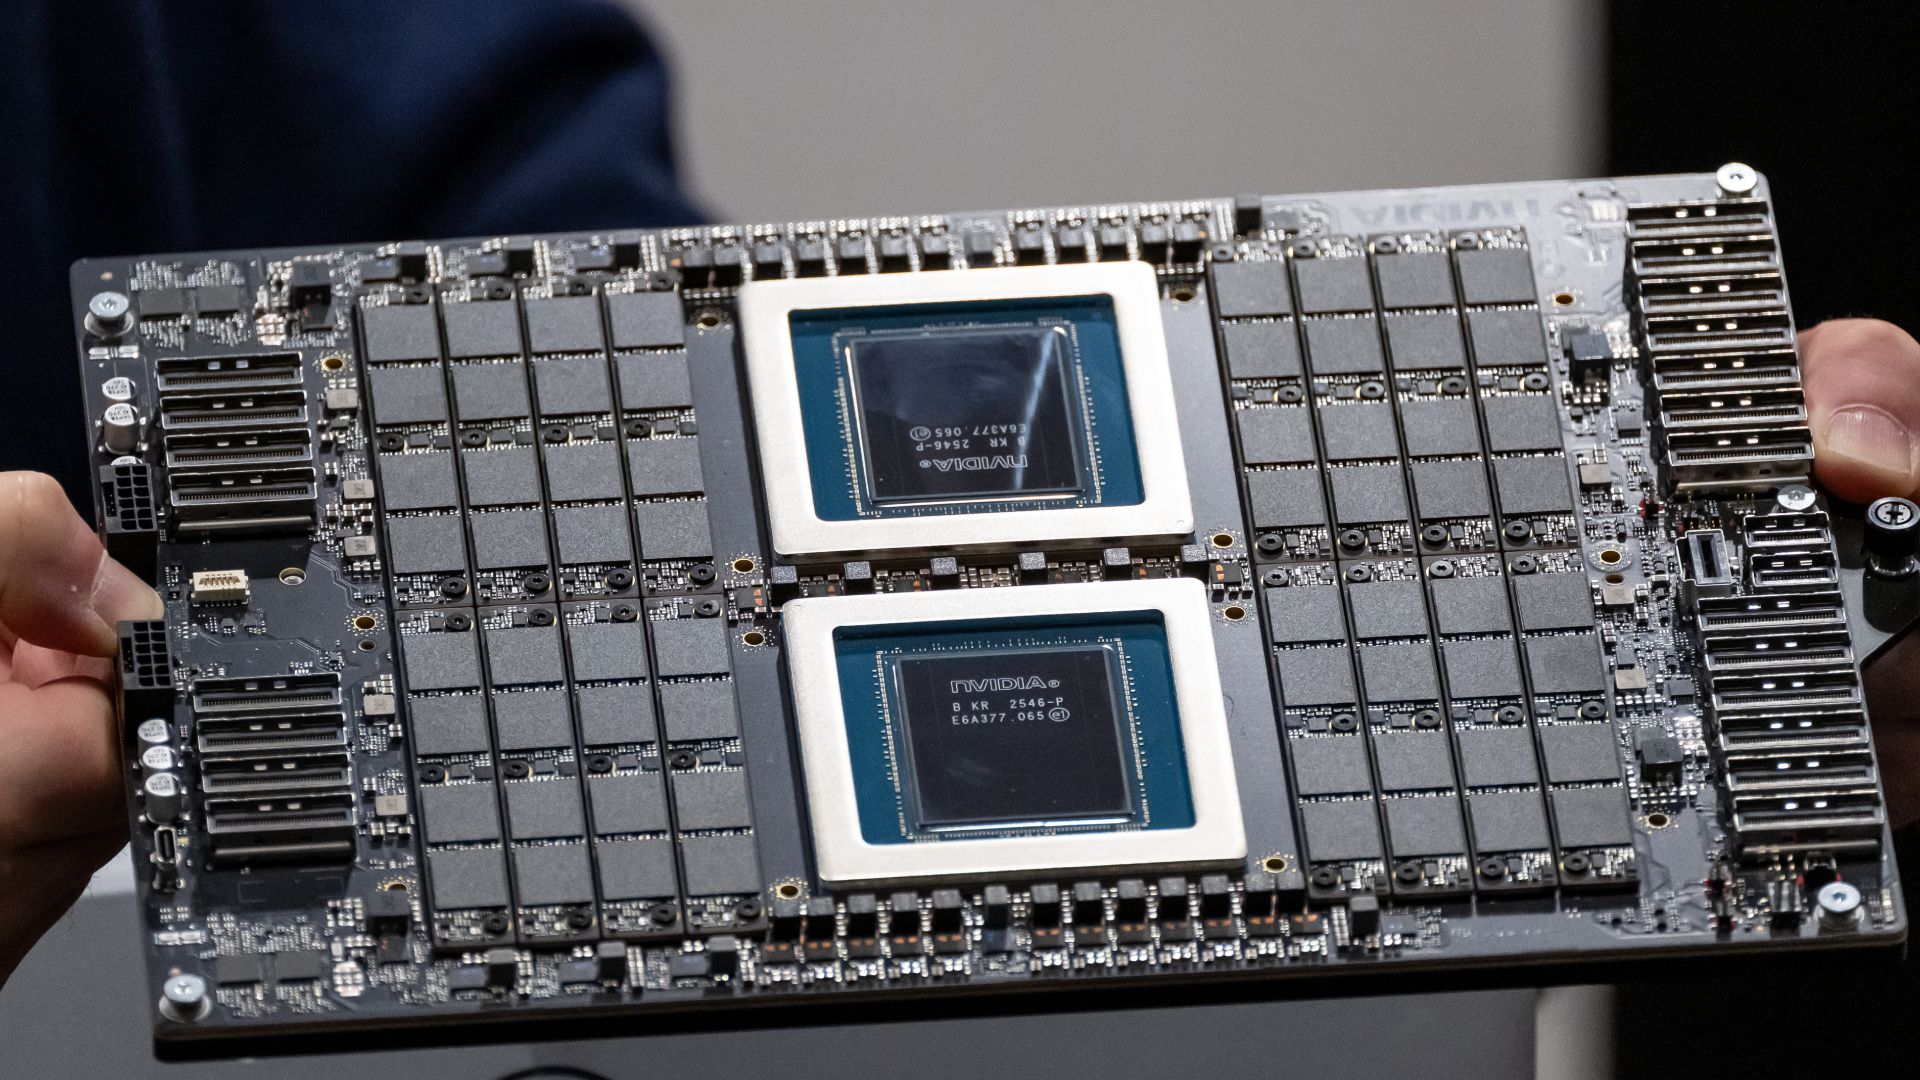
Silikon düzeyinde Vera mimarisi, geleneksel x86 tasarım felsefelerinden keskin bir şekilde sapmaktadır. Çağdaş Intel ve AMD tekliflerinin karakteristiği olan merkezi bellek denetleyicilerine ve devasa sistem düzeyindeki önbelleklere güvenmek yerine Vera, gelişmiş dağıtık örgü önbellek (distributed mesh cache) ile birleştirilmiş monolitik bir kalıp düzeni kullanmaktadır. Bu tescilli düzen, Nvidia’nın ikinci nesil Ölçeklenebilir Tutarlılık Kumaşı'nı (Scalable Coherency Fabric - SCF) destekleyerek verilerin silikon substrat boyunca nasıl hareket ettiğini kökten değiştirmektedir.
Bu topoloji, belleğe dayalı yürütme vektörlerinde devasa getiriler sağlamaktadır. Yüksek hızlı LPDDR5X-9600 bellek modüllerini kullanan Vera, standart kurumsal taban çizgilerini tamamen alt üst eden teorik ve deneysel olarak doğrulanmış bir bellek bant genişliği profili elde eder. Örgü genelinde süreçleri fiziksel olarak olabildiğince birbirinden uzaklaştıran OpenMP "yayma" (spread) politikası gibi gelişmiş süreç bağlama teknikleri kullanılarak uygun şekilde bütçelendiğinde mimari, çift soketli kurumsal ortamlarda geleneksel halka veya örgü ara bağlantılarının tipik olarak dayattığı darboğazları engeller.
Deneysel Özellikler ve Kıyaslama Matrisi
| Metrik / Özellik | Nvidia Vera (Bağımsız) | Intel Xeon 6980P (Çift Soketli) | AMD EPYC Venice (Öngörülen) |
|---|---|---|---|
| Bellek Türü | LPDDR5X-9600 | MRDIMM (8.800 MT/s) | 16 Kanallı DDR5 |
| Stream Triad Bant Genişliği | >1,2 TB/s (Ölçülen zirve) | ~0,55 TB/s | Ölçeklendirilmiş Yüksek Yoğunluk |
| Ara Bağlantı Kumaşı | 2. Nesil Ölçeklenebilir Tutarlılık Kumaşı | Ultra Path Interconnect (UPI) | Infinity Fabric |
| Soket Yoğunluğu | Monolitik Kalıp / Örgü | Çift Soketli Mimari | Soket Başına 512 İş Parçacığına Kadar |
Bağımsız kıyaslama analizi, Nvidia'nın iddialı performans iddialarını doğrulamaktadır. Endüstri standardı Stream kıyaslamasında, Vera'nın Triad operasyonu, ikincisi 8.800 MT/s hızında çalışan son teknoloji MRDIMM'lerle donatılmış olsa bile, çift Intel Xeon 6980P sisteminde mevcut toplam bellek bant genişliğini iki katından fazla artırmaktadır. Bu şaşırtıcı bant genişliği avantajı doğrudan gerçek dünya görevlerine dönüşmektedir; deneysel SQLite veritabanı sorgu değerlendirmeleri, Vera'nın SCF'sinin sistem genelindeki veri hareketi nedeniyle doğal olarak darboğaz oluşturan yürütme yollarını verimli bir şekilde hızlandırdığını göstermektedir.
Termal, Verimlilik ve Gerçek Dünya Ergonomisi
Python temelleri üzerine kurulmuş CrewAI ve LangGraph gibi modern yapay zeka çerçevelerini destekleyenler gibi karmaşık aracılı döngülerin yürütülmesi, bellek ve çekirdek yürütme birimleri arasında sürekli verim gerektirir. Python'un yorumlanan doğası geleneksel olarak bellek gecikmesi ve bant genişliği üzerinde ağır bir vergi uygular, bu da Vera'nın LPDDR5X entegrasyonunu ideal bir fiziksel eşleşme haline getirir. PyBench değerlendirmelerinde Vera, katı bir şekilde acımasız bellek beslemesi nedeniyle üstün kağıt özelliklerine sahip rakip silikonlardan sürekli olarak daha iyi performans göstermektedir.
Bununla birlikte, çok gigawatt'lık kurumsal ortamlara yeni bir mimari getirmek operasyonel dikkat gerektirir. Oracle'ın çok yönlü dağıtım stratejisi (bağımsız Vera örneklerini, ikili 64 çekirdekli Intel Xeon 6 ana bilgisayarları ve 4 TB DDR5 ile eşleştirilmiş HGX NVL8 gibi hibrit konfigürasyonların yanında sunması), ölçülü bir geçişi göstermektedir. Sürdürülebilir aracılı iş yükleri altında çalışan yoğun, yüksek bant genişliğine sahip LPDDR5X dizilerinin ve monolitik kalıpların termal yönetimi, OCI Supercluster'ların sunmak üzere özel olarak tasarlandığı güçlü sıvı veya gelişmiş hava soğutma topolojileri gerektirir.
Kesin Karar
Nvidia’nın Vera CPU'su, Rubin GPU ekosistemi için sadece bir yan ürün olmaktan çok ötedir. Deneysel testlerimiz, dağıtık örgü önbelleğinin ve göz alıcı LPDDR5X-9600 bellek alt sisteminin, belleğe bağlı, son derece eşzamanlı iş yüklerinde kesin bir zafer sağladığını ve Stream ile SQLite metriklerinde eski çift soketli x86 konfigürasyonlarını rahatlıkla geride bıraktığını doğrulamaktadır. AMD ve Intel soket başına saf iş parçacığı yoğunluğu tahtını korurken Vera, gelişen aracılı yapay zeka çağında topoloji ve bant genişliğinin ham çekirdek sayılarını yenebileceğini kanıtlamaktadır. Ağır veri taşıma darboğazlarıyla uğraşan hiper-ölçekleyiciler ve işletmeler için Vera, geleneksel sunucu silikonuna karşı zorlu, yüksek düzeyde yıkıcı bir alternatif olarak ortaya çıkmaktadır.