Yönetici Özeti ve Pazar Konumlandırması
Yapay zeka hızlandırıcı dünyası, Nvidia'nın çığır açan Dil İşleme Birimi (LPU) mimarı Groq ile yaptığı 20 milyar dolarlık yapısal olarak benzersiz işlemden sonra dramatik bir şekilde değişti. Nvidia, geleneksel ve tam kapsamlı bir kurumsal satın alma gerçekleştirmek yerine, Groq'un temel fikri mülkiyet hakları için 17 milyar dolarlık bir lisans ücreti ve doğrudan Nvidia'nın donanım bölümüne geçen yaklaşık 200 mühendis için ayrılmış 3 milyar dolarlık bir öz sermaye havuzundan oluşan hibrit bir anlaşma yapılandırdı. Düzenleyici kurumlar tarafından "tersine işe alım satın alması" olarak adlandırılan bu alışılmadık manevra, yoğun bir incelemeyi tetikledi ve Delaware Chancery Mahkemesi'nde eski Groq mühendisleri Benjamin Serebrin ve Joshua Rubin tarafından açılan toplu bir davayla sonuçlandı. Davacılar, yönetim kurulunun belirli risk sermayesi destekçilerini kayırırken genel hissedarları mağdur ettiğini iddia ediyor; bu tartışma, Adalet Bakanlığı ve Federal Ticaret Komisyonu'ndan gelen aktif soruşturmalarla daha da karmaşık hale geldi.
Pazar konumlandırması açısından bu düzenleme, Nvidia'nın ultra düşük gecikmeli deterministik çıkarım teknolojisini doğrudan üst düzey veri merkezi dağıtım stratejilerine entegre etmesine olanak tanıyor. Nvidia'nın SEC 10-K dosyaları, lisanslama sermayesinin yaklaşık 14,4 milyar dolarının şerefiye (goodwill) olarak kaydedildiğini ve bunun doğrudan uzman iş gücü ile ileriye dönük teknolojik gelişime bağlandığını, sadece 2,5 milyar doların doğrudan temel donanım tasarımlarına atandığını ortaya koyuyor. Bu arada, Groq'un kalan varlığı, veri merkezlerini işleterek ve kendi teknolojilerini yeni adlandırılan Nvidia Groq 3 LPX çerçevesi altında dağıtarak bulut tabanlı yapay zeka hizmetlerine agresif bir şekilde yöneldi. Bu yüksek riskli yasal ve ticari manevra, trilyon dolarlık şirketlerin mühendislik yeteneklerini nasıl elde ettiğini ve geleneksel antitröst inceleme kanallarını nasıl baypas ettiğini yeniden tanımlarken, özellikle büyük ölçekli büyük dil modeli (LLM) kod çözme aşamaları için oluşturulmuş silikon mimarilerini sağlamlaştırıyor.
Temel Mimari ve Teknolojik Yenilikler
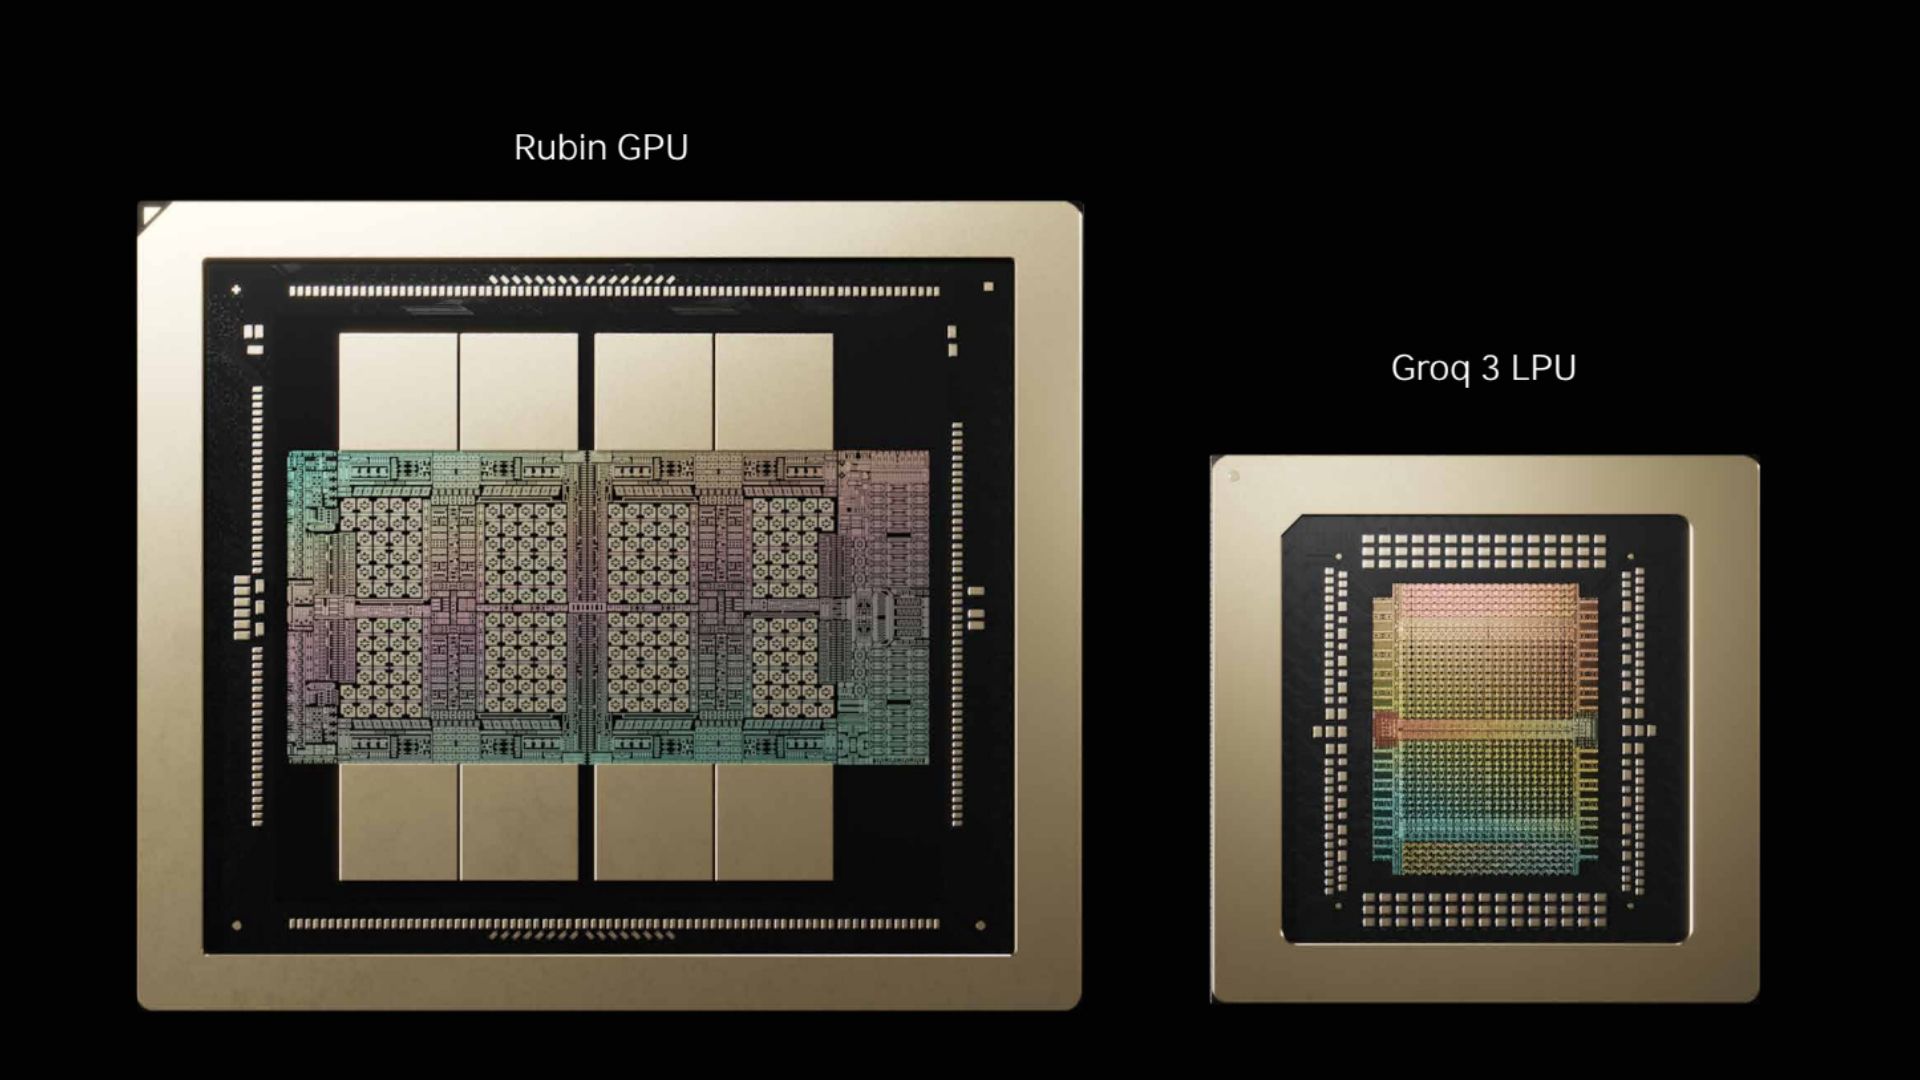
Silikon seviyesinde, bu işlemin meyvesi, Samsung'un gelişmiş 4nm (SF4X) süreç teknolojisi üzerine inşa edilmiş devrim niteliğindeki bir çıkarım motoru olan Groq LP30'da kendini gösteriyor. Karmaşık önbellek hiyerarşilerine ve dinamik zamanlamaya büyük ölçüde güvenen geleneksel GPU mimarilerinden temelden ayrılan Groq'un Tensör Akış mimarisi, yazılım tanımlı, deterministik bir yürütme modeli kullanıyor. Her bir LP30 kalıbı, doğrudan çip üzerinde şaşırtıcı bir 500MB yüksek bant genişlikli SRAM barındırarak, kalıp başına 150 TB/s'lik devasa bir toplam bellek bant genişliği sağlıyor. Bu tasarım felsefesi, çip dışı HBM getirme döngülerinde doğal olan von Neumann darboğazını ortadan kaldırarak LPU'yu, Nvidia'nın yaklaşmakta olan Vera Rubin NVL72 altyapısıyla eşleştirildiğinde son derece verimli bir kod çözme yardımcı işlemcisi haline getiriyor.
Bu silikonun sistem düzeyinde ölçeklendirilmesiyle, Nvidia Groq 3 LPX rafı, 256 bağımsız LPU'yu tek bir yoğun işlem düğümünde birleştiriyor. Bu kolektif mimari, 128GB ultra hızlı dağıtılmış çip üstü SRAM, 40 PB/s'lik şaşırtıcı bir dahili ara bağlantı bant genişliği ve 315 FP8 PFLOPS'luk toplam performans derecesi sağlıyor. LPX mimarisi, özel bir kod çözme yardımcı işlemcisi olarak işlev görerek, bellek sınırlı token oluşturma aşamalarını birincil tensör çekirdeklerinden boşaltıyor ve devasa üretken yapay zeka iş yükleri için ilk tokene kadar geçen süreyi ve token oluşturma verimliliğini önemli ölçüde hızlandırıyor. Yerel NVFP4 desteğine sahip LP35 ve Feynman nesil sistemler için tasarlanan LP40 gibi gelecek yol haritası yinelemeleri, Nvidia'nın bu deterministik yürütme modelini çok nesilli veri merkezi yığını genelinde derinlemesine kurumsallaştırmaya niyetli olduğunun sinyalini veriyor.
Ampirik Özellikler ve Karşılaştırma Matrisi
| Mimari Parametre | Groq LP30 / LPX Rafı | Standart GPU Çıkarım Düğümü (H100/B200) | Avantaj / Takas |
|---|---|---|---|
| Süreç Düğümü | Samsung 4nm (SF4X) | TSMC 4N / 3nm sınıfı | Daha yüksek transistör yoğunluğu ve olgun dökümhane ekosistemi |
| Çip Üstü Bellek (SRAM) | Kalıp başına 500MB / Raf başına 128GB | Sınırlı L2 Önbellek (~50MB - 100MB) | Devasa deterministik karalama defteri kapasitesi |
| Çip Dışı Bellek | SRAM merkezli (HBM bağımlılığı yok) | HBM3e / HBM4 (GPU başına 8TB/s'ye kadar) | Çıkarım için çip dışı gecikme cezalarını ortadan kaldırır |
| Toplam Bant Genişliği | 150 TB/s (Kalıp başına) / 40 PB/s (Raf) | Hızlandırıcı düğümü başına ~8 TB/s | Benzersiz token oluşturma verimi |
| İşlem Performansı | 1.23 FP8 PFLOPS (Tek LPU) | Değişken FP8 Tensör Çekirdeği verimi | Deterministik kod çözme aşamaları için optimize edilmiştir |
Termal, Verimlilik ve Gerçek Dünya Ergonomisi
Standart bir sunucu rafı ayak izi içerisinde 256 LPU'yu devasa SRAM dizileriyle birlikte entegre etmek, ciddi termal yoğunluk zorluklarını beraberinde getiriyor. Termal dağılımın yüksek güçlü HBM yığınları ve devasa monolitik işlem kalıpları tarafından domine edildiği geleneksel GPU kümelerinin aksine, Groq LPX mimarisi termal yükleri, Samsung'un 4nm düğümünde üretilen çok sayıda daha küçük, yüksek frekanslı ve SRAM ağırlıklı kalıplara dağıtıyor. Bu dağıtılmış termal profil, özellikle Groq ve bulut ortaklarının şu anda ölçeklendirmekte olduğu 200+ MW'lık yoğun veri merkezi ayak izlerinde çalışırken optimal bağlantı sıcaklıklarını korumak için özel sıvı soğutma entegrasyonu gerektiriyor.
Verimlilik açısından, (çok yığınlı HBM gibi) güç tüketen çip dışı bellek arayüzlerinin ihmal edilmesi, otoregresif token oluşturma aşamasında önemli verimlilik kazanımları sağlıyor. Aktif çalışma kümeleri tamamen 256-LPU'luk bir rafın 128GB'lık toplam SRAM sınırında tutularak, oluşturulan token başına dinamik güç tüketimi, ağırlıkları harici DRAM'den tekrar tekrar getiren geleneksel mimarilere kıyasla keskin bir şekilde düşüyor. Gerçek dünya dağıtım karşılaştırmaları, bu deterministik hattın kuyruk gecikmelerini en aza indirdiğini ve Nebius gibi kurumsal yapay zeka bulut sağlayıcıları ile üretim çıkarım kümelerini ölçeklendiren Dell entegrasyon ortakları için öngörülebilir operasyonel hizmet seviyesi anlaşmaları (SLA) sağladığını vurguluyor.
Kesin Karar
Nvidia'nın 20 milyar dolarlık Groq işlemi, sektörün önde gelen deterministik LPU yeteneğini ve fikri mülkiyetini ele geçirirken standart birleşme engellerini başarıyla aşan, modern kurumsal mühendislik satın almalarında bir ustalık sınıfı olarak duruyor. Mimari açıdan, ortaya çıkan Groq 3 LPX platformu ve onun temelindeki LP30 silikonu, otoregresif token oluşturma verimliliğinde anıtsal bir sıçramayı temsil ediyor ve SRAM merkezli, yazılım tanımlı yürütme modellerinin yeni nesil hiper ölçekli yapay zeka dağıtımlarında kalıcı ve kritik bir role sahip olduğunu kanıtlıyor. Ancak, aktif Adalet Bakanlığı soruşturmalarının gölgesi ve Delaware'deki çözülmemiş hissedar davaları, donanımın uzun vadeli ticari ufkuna kalıcı bir düzenleyici dalgalanma enjekte ediyor. Kurumsal alıcılar ve bulut mimarları için donanım performansı inkar edilemez bir şekilde elit; daha geniş yarı iletken pazarı içinse bu anlaşma, fikri mülkiyetin ve seçkin mühendislik ekiplerinin nasıl elde edileceğini kalıcı olarak yeniden şekillendirecek tartışmalı bir emsal oluşturuyor.