Résumé analytique et positionnement sur le marché
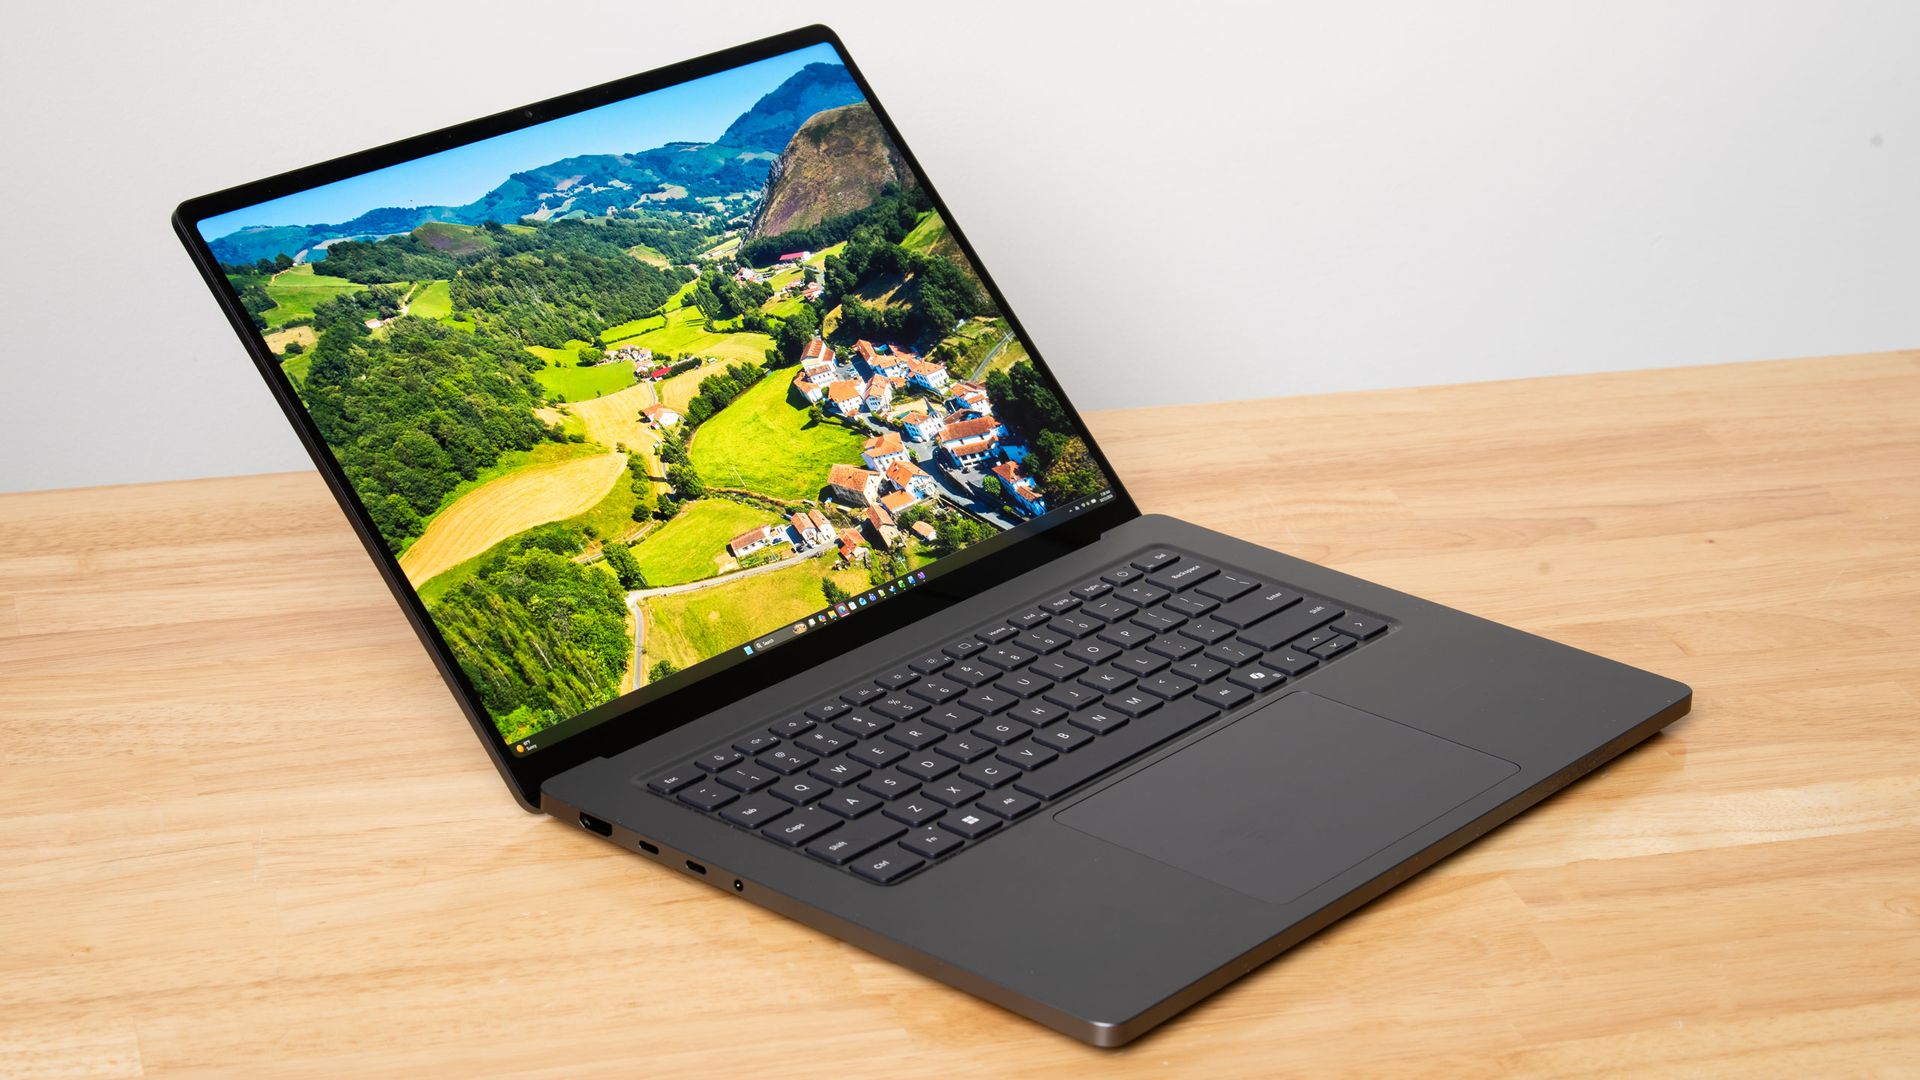
Le paradigme informatique évolue rapidement, passant d'une exécution logicielle statique à des flux de travail d'agents autonomes et dynamiques. L'introduction par Nvidia de la plateforme RTX Spark, ancrée par le Superchip GB10, représente un pari calculé pour réinventer l'architecture des PC portables. Évaluée au sein du Surface Laptop Ultra haut de gamme de Microsoft — équipé de 128 Go de RAM LPDDR5X-9400 — cette pile matérielle cible les utilisateurs professionnels, les opérateurs d'entreprise et les praticiens de l'IA locale intensive. L'objectif stratégique de Nvidia est clair : intégrer des capacités d'inférence et de calcul parallèle de qualité centre de données dans un châssis élégant et portable.
Cependant, cette convergence matérielle motivée par l'ambition met en évidence des difficultés de croissance générationnelles notables. Bien que les limites d'exécution de l'IA locale soient entièrement réécrites par l'architecture massivement parallèle du Spark, les charges de travail localisées traditionnelles et la maturité de l'écosystème logiciel racontent une histoire plus nuancée. Positionnée directement face au silicium M5 Max d'Apple et aux systèmes Ryzen AI Halo d'AMD, la plateforme RTX Spark se forge une identité opérationnelle distincte. Elle sacrifie le débit brut du CPU et le pédigrée d'exécution des jeux en échange d'une vitesse d'exécution de tâches d'agents de bout en bout sans précédent, établissant une nouvelle référence pour ce que le matériel neuronal local peut accomplir dans un format mobile.
Innovations architecturales et technologiques clés
Au niveau du silicium, la plateforme RTX Spark repose sur une conception hétérogène associant un complexe CPU à 20 cœurs (doté de cœurs d'architecture Arm dérivés de MediaTek) à un GPU monstrueux de 6 144 cœurs CUDA comprenant 48 multiprocesseurs de streaming. Cette disposition est spécifiquement optimisée pour l'exécution de transformateurs localisés, les schémas de décodage spéculatif comme DFlash2 et les pipelines de prédiction multi-jetons (MTP). En intégrant 128 Go de mémoire LPDDR5X-9400 ultra-rapide directement dans le sous-système de mémoire unifiée, Nvidia contourne les goulets d'étranglement traditionnels de la bande passante PCIe qui handicapaient historiquement l'exécution des grands modèles de langage (LLM) sur le matériel client.
Malgré ces triomphes architecturaux, les performances brutes du CPU révèlent le talon d'Achille actuel de la plateforme. Lors des évaluations Geekbench mono-cœur et multi-cœur, le complexe CPU Arm fourni par MediaTek accuse un retard visible sur le silicium M5 Max d'Apple. Le Spark ne semble pas poussif lors de la navigation de bureau courante ou des tâches de productivité de base, mais les charges de travail de compilation lourdes et les calculs sérialisés liés au CPU exposent un déficit de performances par rapport aux architectures matures. Pourtant, lorsqu'on lui confie des modèles d'intelligence localisée complexes comme le dense Qwen 3.8-27B ou le mélange d'experts Qwen 3.6 35B A3B, la disposition des cœurs CUDA libère un débit parallèle massif, rendant les disparités du CPU négligeables lors des tâches d'agents.
Spécifications empiriques et matrice de référence
| Fonctionnalité / Métrique | Nvidia RTX Spark (Surface Laptop Ultra) | Apple M5 Max (MacBook Pro 14") | AMD Ryzen AI Halo (Strix Halo) | Avantage architectural / Remarques |
|---|---|---|---|---|
| Nombre de cœurs CPU | 20 cœurs (basé sur Arm) | 18 cœurs (Apple Silicon) | Zen 5 + Moteur XDNA 2 | Apple est en tête en IPC CPU brut mono/multi-thread. |
| Unités de calcul GPU | 6 144 cœurs CUDA (48 SM) | GPU 40 cœurs / Metal | RDNA 3.5 intégré | Nvidia domine dans l'accélération vectorielle parallèle brute. |
| Mémoire système | 128 Go LPDDR5X-9400 | 128 Go LPDDR5X | Jusqu'à 128 Go unifiés | Une bande passante élevée est essentielle pour les MoE et les LLM denses. |
| AgentPerf-local (27B) | Le plus rapide (env. 25 % plus rapide que le Mac) | Compétitif, limité par la mémoire | ~40 minutes (nettement plus lent) | L'architecture Spark minimise la latence des agents de bout en bout. |
| AgentPerf-local (35B) | Temps de fin : 8 minutes | Temps de fin : 10 minutes | Temps de fin : 13 minutes | Démontre un débit de génération de jetons supérieur. |
Thermique, efficacité et ergonomie réelle
L'analyse de l'enveloppe thermique et électrique du Surface Laptop Ultra révèle le réglage agressif requis pour maintenir la plateforme RTX Spark. Tirant de l'énergie d'un adaptateur secteur robuste de 140 W — correspondant au niveau utilisé par les grands MacBook de 16 pouces — ce châssis de 15 pouces s'appuie largement sur la marge de dissipation thermique. Bien que le profilage complet de l'autonomie de la batterie reste restreint en raison des contraintes d'embargo actuelles sur le lancement, la conception thermique privilégie clairement la fourniture de calculs soutenus par rapport à une efficacité passive et sans ventilateur.
Lors de l'exécution de charges de travail d'agents exigeantes via la suite AgentPerf-local d'Artificial Analysis, le matériel maintient efficacement l'équilibre thermique, évitant un bridage thermique agressif. Le système a terminé le balayage d'inférence du modèle dense Qwen 3.8-27B 25 % plus rapidement que le MacBook Pro M5 Max de 14 pouces, une victoire partiellement attribuable à l'enveloppe de puissance généreuse et à la conception de refroidissement actif du châssis Surface. À l'inverse, le format compact de classe bureau Ryzen AI Halo d'AMD a nécessité environ deux fois plus de temps d'exécution pour accomplir des charges de travail d'agents identiques, soulignant que l'efficacité architecturale brute et la fourniture d'énergie soutenue ne sont pas négociables pour l'exécution d'IA professionnelle.
Le verdict définitif
La plateforme RTX Spark de Nvidia à l'intérieur du Microsoft Surface Laptop Ultra est un triomphe de l'ingénierie matérielle spécialisée pour l'ère de l'IA. Elle s'empare de manière décisive de la couronne pour l'exécution des tâches d'agents locaux, surpassant le M5 Max d'Apple et le Strix Halo d'AMD dans les repères d'inférence LLM complexes à plusieurs tours comme AgentPerf-local. Pour les développeurs, les data scientists et les utilisateurs puissants dont les flux de travail quotidiens dépendent d'une exécution rapide de modèles locaux et de la productivité d'agents autonomes, l'architecture Spark justifie son positionnement matériel haut de gamme.
Cependant, il ne s'agit pas d'une panacée universelle pour le grand public. Les cœurs CPU de la plateforme dérivés de MediaTek sont à la traîne des architectures concurrentes en matière de puissance de traitement brute, et l'écosystème logiciel précoce entourant la plateforme nécessite un raffinement continu. De plus, malgré sa forte image de marque RTX et son nombre massif de cœurs CUDA, les performances de jeu traditionnelles restent un point fort secondaire et sous-développé, ce qui signifie que les acheteurs potentiels doivent évaluer ce système sous l'angle de la productivité d'entreprise plutôt que sous celui du divertissement grand public. En fin de compte, le RTX Spark réinvente avec succès la station de travail PC professionnelle, à condition que votre définition du travail soit entièrement axée sur l'intelligence artificielle.