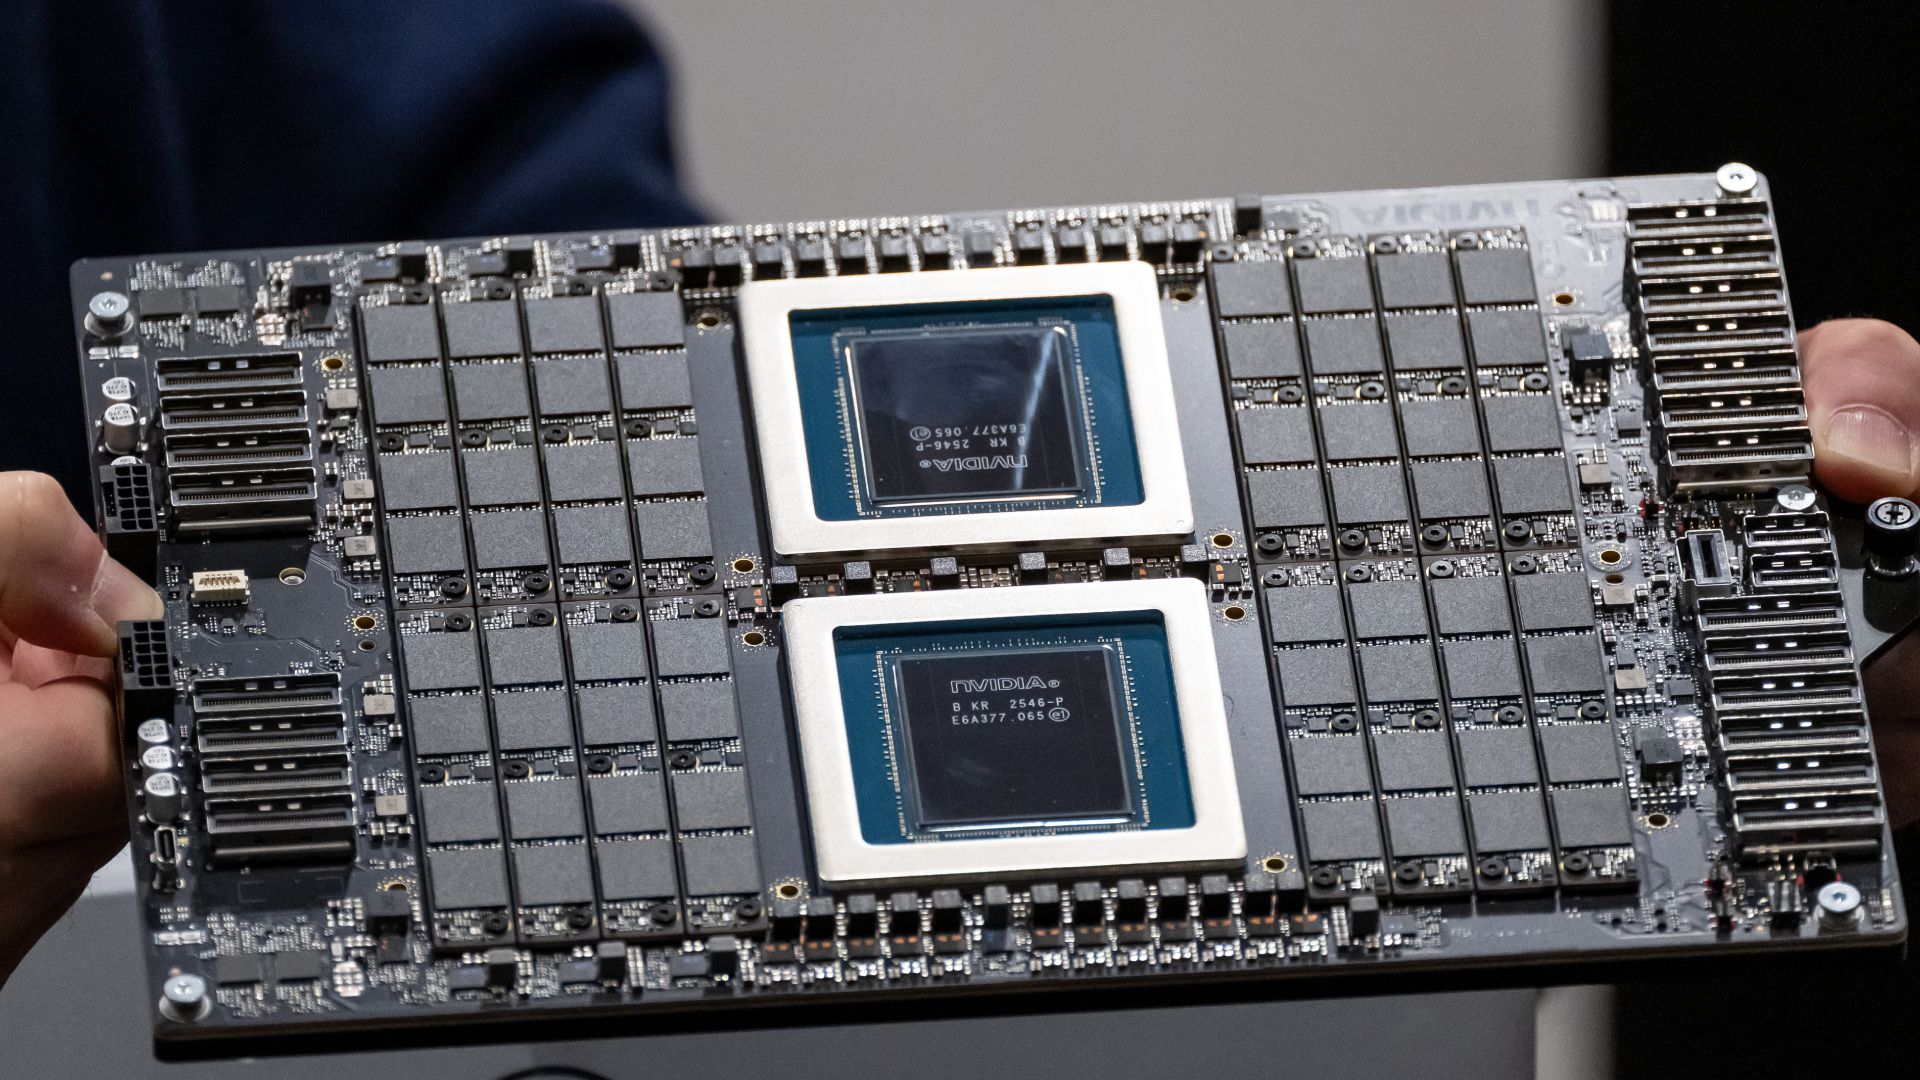
Résumé exécutif et positionnement sur le marché
L'annonce de la disponibilité générale des CPU Vera de Nvidia au sein des superclusters Oracle Cloud Infrastructure (OCI) marque un tournant décisif dans l'architecture des serveurs d'entreprise. Alors que les néoclouds tels que Nscale, CoreWeave et Nebius se sont fortement orientés vers des déploiements axés sur les GPU, l'intégration stratégique par Oracle d'instances Vera autonomes signale un changement profond. Il s'agit du tout premier essai de Nvidia consistant à imposer un CPU indépendant et non accéléré directement dans le grand public des centres de données hyperscale, préparant ainsi le terrain pour une collision frontale avec l'hégémonie x86 bien établie, dominée par Intel et AMD.
Historiquement, la stratégie de calcul pour centres de données de Nvidia a étroitement associé ses CPU propriétaires à ses GPU de pointe. Cependant, la disponibilité autonome de Vera chez un hyperscaler de premier plan comme Oracle brise ce moule. Elle positionne l'architecture non seulement comme un processeur hôte auxiliaire pour les matrices Rubin ou Blackwell, mais aussi comme un nœud de calcul généraliste à part entière. Alors que les futurs concurrents tels que l'EPYC Venice à 256 cœurs d'AMD ciblent la densité brute de threads par socket, le pari calculé de Nvidia avec Vera donne la priorité à la topographie et à l'efficacité du sous-système mémoire. Cette différenciation stratégique vise à capturer le marché en expansion rapide des charges de travail à forte concurrence et gourmandes en données.
Innovations architecturales et technologiques clés
Au niveau du silicium, l'architecture Vera s'écarte radicalement des philosophies de conception x86 traditionnelles. Plutôt que de s'appuyer sur des contrôleurs mémoire centralisés et des caches massifs au niveau du système caractéristiques des offres contemporaines d'Intel et d'AMD, Vera utilise une disposition de matrice monolithique combinée à un cache maillé distribué sophistiqué. Cette disposition propriétaire sous-tend la deuxième génération de la structure de cohérence évolutive (SCF) de Nvidia, modifiant fondamentalement la façon dont les données traversent le substrat de silicium.
Cette topographie rapporte des dividendes massifs dans les vecteurs d'exécution liés à la mémoire. En utilisant des modules mémoire LPDDR5X-9600 à haute vitesse, Vera atteint un profil de bande passante mémoire théorique et empiriquement validé qui perturbe en profondeur les références standard des entreprises. Lorsqu'elle est correctement exploitée à l'aide de techniques avancées de liaison de processus — telles que la politique « spread » d'OpenMP qui éloigne le plus possible physiquement les processus à travers le maillage —, l'architecture contourne les goulets d'étranglement généralement imposés par les interconnexions en anneau ou en maillage traditionnelles que l'on trouve dans les environnements d'entreprise à double socket.
Spécifications empiriques et matrice de benchmarks
| Métrique / Fonctionnalité | Nvidia Vera (Autonome) | Intel Xeon 6980P (Double socket) | AMD EPYC Venice (Prévu) |
|---|---|---|---|
| Type de mémoire | LPDDR5X-9600 | MRDIMM (8 800 MT/s) | DDR5 à 16 canaux |
| Bande passante Stream Triad | >1,2 To/s (Pic mesuré) | ~0,55 To/s | Haute densité mise à l'échelle |
| Structure d'interconnexion | Structure de cohérence évolutive de 2e génération | Ultra Path Interconnect (UPI) | Infinity Fabric |
| Densité de sockets | Matrice monolithique / Maillage | Architecture à double socket | Jusqu'à 512 threads / socket |
L'analyse de benchmarks indépendants corrobore les déclarations agressives de Nvidia en matière de performances. Dans le benchmark standard de l'industrie Stream, l'opération Triad de Vera double plus que la bande passante mémoire agrégée disponible sur un système double Intel Xeon 6980P, même lorsque ce dernier est équipé de modules MRDIMM de pointe fonctionnant à 8 800 MT/s. Cet avantage de bande passante stupéfiant se traduit directement par des tâches du monde réel ; les évaluations empiriques de requêtes de bases de données SQLite démontrent que la structure SCF de Vera accélère efficacement les chemins d'exécution qui sont intrinsèquement bloqués par le mouvement des données à l'échelle du système.
Thermique, efficacité et ergonomie du monde réel
L'exécution de boucles agentiques complexes — telles que celles alimentant les frameworks d'IA modernes comme CrewAI et LangGraph construits sur des fondations Python — nécessite un débit soutenu à travers la mémoire et les unités d'exécution principales. La nature interprétée de Python impose traditionnellement un lourd tribut à la latence et à la bande passante de la mémoire, faisant de l'intégration LPDDR5X de Vera une correspondance physique idéale. Dans les évaluations PyBench, Vera surpasse régulièrement sa catégorie de poids, surpassant les siliciums concurrents qui affichent des spécifications théoriques supérieures strictement en raison de son alimentation mémoire implacable.
Cependant, l'introduction d'une architecture novatrice dans des environnements d'entreprise de plusieurs gigawatts exige de la prudence opérationnelle. La stratégie de déploiement à volets multiples d'Oracle — proposant des instances Vera autonomes parallèlement à des configurations hybrides telles que le HGX NVL8 associé à deux hôtes Intel Xeon 6 à 64 cœurs et 4 To de DDR5 — illustre une transition mesurée. La gestion thermique des réseaux LPDDR5X denses et à haute bande passante et des matrices monolithiques fonctionnant sous des charges de travail agentiques soutenues nécessite des topologies de refroidissement liquide ou à air avancé, que les superclusters OCI sont spécifiquement conçus pour fournir.
Le verdict définitif
Le CPU Vera de Nvidia est bien plus qu'un simple module d'accompagnement pour l'écosystème de GPU Rubin. Nos tests empiriques confirment que son cache maillé distribué et son sous-système mémoire LPDDR5X-9600 fulgurant offrent une victoire décisive dans les charges de travail fortement concurrentes et liées à la mémoire, surpassant confortablement les configurations x86 héritées à double socket dans les métriques Stream et SQLite. Alors qu'AMD et Intel conservent la couronne de la densité de threads pure par socket, Vera prouve que la topographie et la bande passante peuvent l'emporter sur le nombre brut de cœurs à l'ère de l'IA agentique émergente. Pour les hyperscalers et les entreprises confrontés à de lourds goulets d'étranglement liés au déplacement des données, Vera s'impose comme une alternative redoutable et hautement perturbatrice au silicium de serveur traditionnel.