Résumé analytique et positionnement sur le marché
Des rapports financiers récents indiquent que SpaceX prépare activement un plan de dette massif de 40 milliards de dollars pour 2027, destiné principalement à l'achat de processeurs d'intelligence artificielle Nvidia de nouvelle génération. Bien que les structures d'entreprise acheminent formellement cette initiative à travers l'écosystème élargi d'Elon Musk, les gains opérationnels ciblent les clusters de calcul hyper-échelle de xAI. Le véhicule financier proposé combinerait 10 milliards de dollars de prêts bancaires directs et 30 milliards de dollars de dette de qualité investissement, avec des poids lourds financiers comme Apollo Global Management et Pimco pressentis pour diriger la structuration. Cet apport de capital sans précédent souligne un changement fondamental dans l'acquisition d'infrastructures à hyper-échelle, dépassant le capital-risque traditionnel et les flux de trésorerie des entreprises pour passer à des instruments de dette à l'échelle souveraine.
Du point de vue du positionnement sur le marché, cette dépense brise les précédents historiques en matière de cycles d'approvisionnement matériel pour une seule entité. S'appuyant sur les déploiements précédents de xAI — tels que les itérations du cluster Colossus tirant parti de centaines de milliers d'accélérateurs d'architecture Blackwell — le calendrier de déploiement de 2027 correspond directement à la prochaine génération Vera Rubin de Nvidia. En verrouillant des milliards dans le financement de matériel dédié des années à l'avance, xAI tente de devancer la pénurie mondiale de silicium, d'obtenir des allocations de fonderie de premier ordre et de maintenir une trajectoire agressive dans la course aux modèles fondamentaux d'IA générative. Cette stratégie traite le silicium avancé non pas simplement comme une dépense en capital, mais comme un actif stratégique principal comparable à une infrastructure industrielle lourde.
Innovations architecturales et technologiques fondamentales
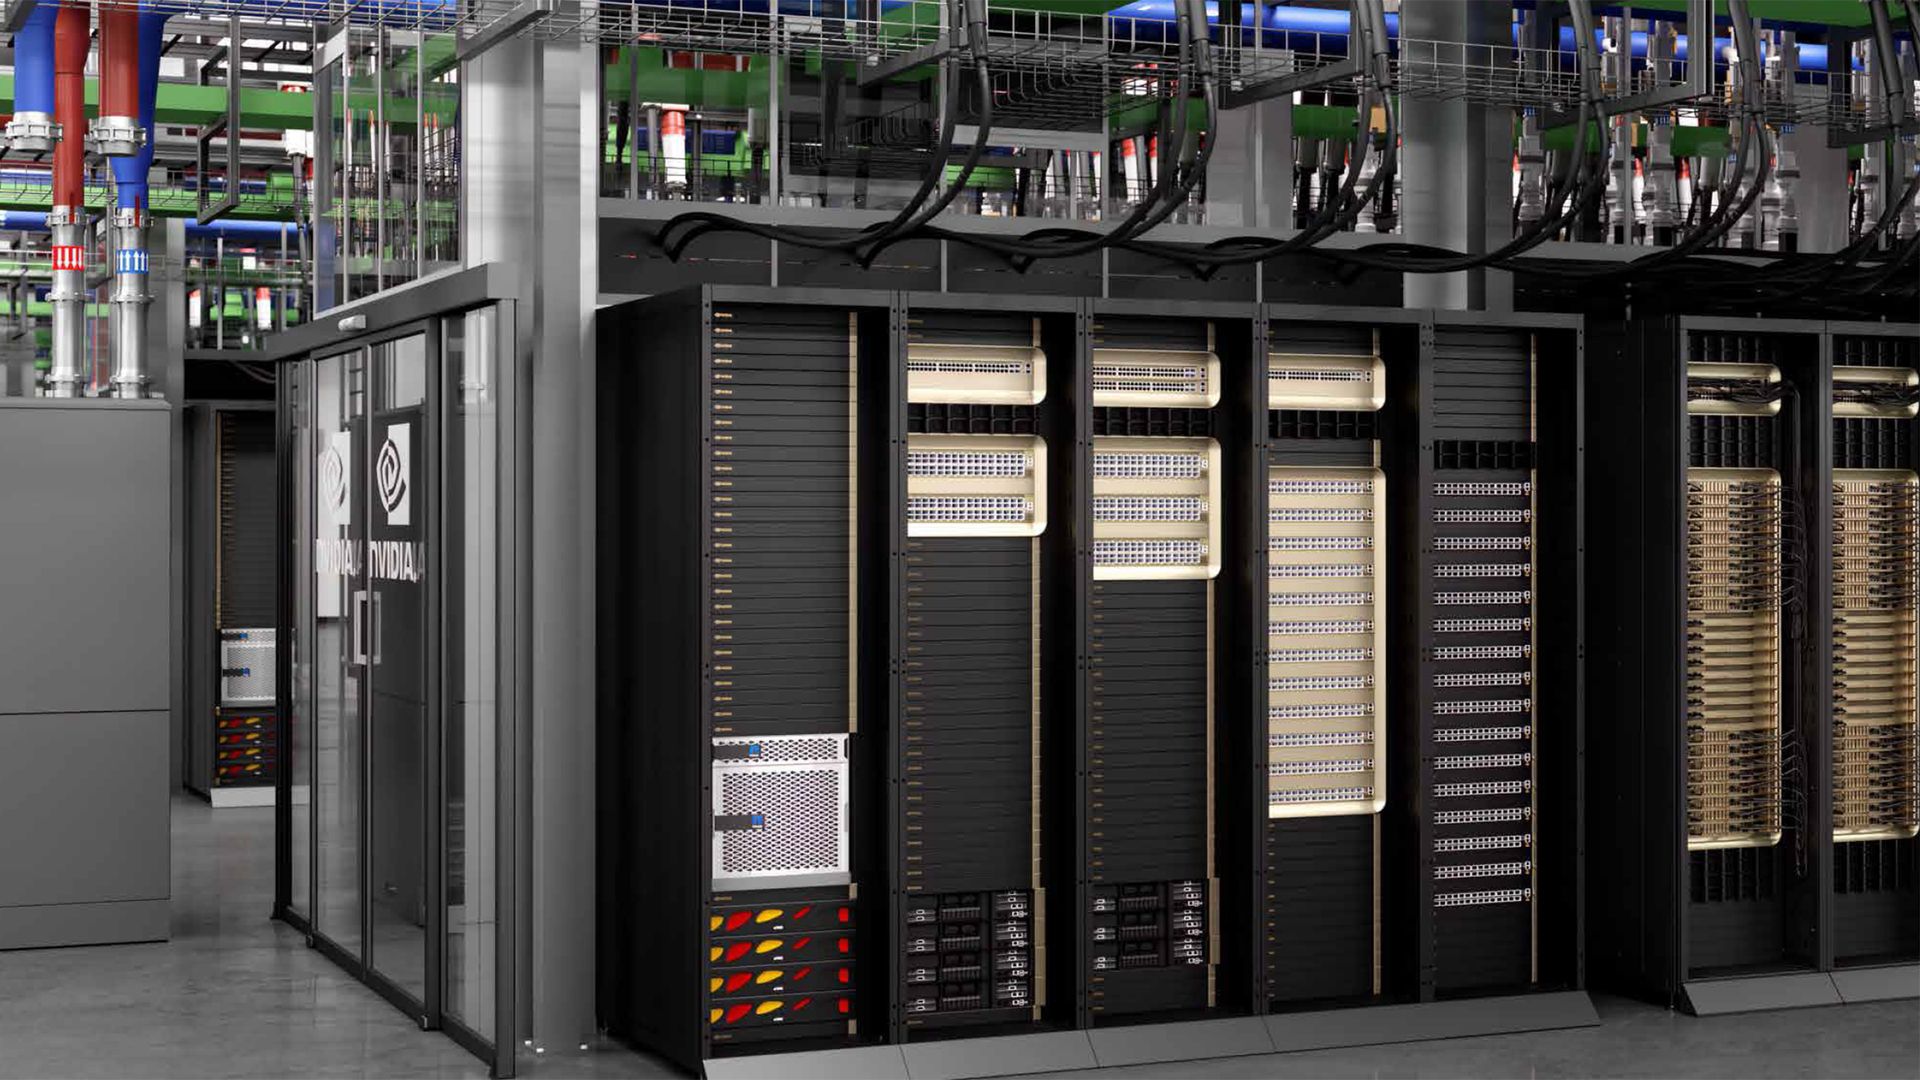
L'ancrage technologique de ces 40 milliards de dollars projetés est la future architecture Vera Rubin de Nvidia, attendue spécifiquement pour être déployée dans des configurations à l'échelle du rack, semblables au Rubin NVL72. Dépassant les paradigmes architecturaux de Hopper et Blackwell, la génération Rubin introduit des refontes majeures des ratios calcul-mémoire, de l'intégration des interconnexions optiques et des tissus de commutation propriétaires NVLink. Avec des unités de rack individuelles atteignant des valorisations astronomiques — estimées à environ 8,8 millions de dollars par assemblage NVL72 — le matériel représente la pointe absolue du calcul hétérogène dense. Chaque rack intègre des processeurs conçus sur mesure, une mémoire à large bande passante avancée (HBM4) et du silicium co-conçu optimisé pour des charges de travail d'inférence et d'entraînement massives basées sur les transformeurs.
À une échelle macroscopique, l'allocation de 40 milliards de dollars à l'écosystème Rubin NVL72 se traduit par environ 5 000 systèmes de rack entièrement intégrés hébergeant environ 360 000 accélérateurs Nvidia Rubin AI individuels. Cette densité modifie radicalement les exigences de topologie des centres de données. Contrairement aux déploiements de serveurs traditionnels où les nœuds sont assemblés de manière incrémentielle à partir de cartes mères et de cartes d'interface disparates, l'approche à l'échelle du rack Rubin traite l'intégralité du châssis de 72 GPU comme un moteur de calcul monolithique unique. Cela minimise les goulots d'étranglement de latence, maximise la bande passante intra-rack via des réseaux d'émetteurs-récepteurs optiques multi-térabits et rationalise l'orchestration complexe requise pour entraîner des modèles fondamentaux de classe frontière sans souffrir de la famine induite par le réseau.
Spécifications empiriques et matrice de référence
| Métrique matérielle | Nvidia Blackwell GB200 (Référence) | Nvidia Vera Rubin NVL72 (Projeté) | Delta architectural |
|---|---|---|---|
| Nœud de processus | TSMC 4NP Personnalisé | Classe Avancée N3 / N2 | Densité de transistors plus élevée et fuite réduite |
| Standard mémoire | HBM3e (jusqu'à 192 Go/pkg) | HBM4 (capacité/largeur de bus étendue) | Augmentation exponentielle de la bande passante mémoire |
| Bande passante interconnexion | 1,8 To/s bidirectionnel par GPU (NVLink) | Tissu de commutation NVLink de nouvelle génération | Latence réduite, efficacité de mise à l'échelle supérieure |
| Coût unitaire estimé | ~3M$ – 4M$ par équivalent rack | ~8,8M$ par rack NVL72 | Reflète l'échelle d'intégration et les primes HBM4 |
| Déploiement cible | 2024–2025 (Itérations Colossus) | 2027 (Fenêtre cible xAI) | Capacité d'entraînement de nouvelle génération |
Thermique, efficacité et ergonomie réelle
Le déploiement d'environ 360 000 accélérateurs Rubin sur 5 000 unités de rack présente des défis thermodynamiques et d'ingénierie des installations sans précédent. Avec des densités de puissance de rack individuelles dépassant largement les 100 kilowatts — et atteignant potentiellement le seuil de 150 kW selon le réglage de la fréquence d'horloge et l'intensité de la charge de travail — le refroidissement par air est totalement obsolète pour cette classe de matériel. Les installations abritant le déploiement de xAI reposeront entièrement sur des boucles de refroidissement liquide-puce avancées, des collecteurs de distribution de liquide de refroidissement (CDM) précis et des échangeurs de chaleur à boucle secondaire haute capacité. La gestion thermique doit maintenir des températures de jonction strictes pour éviter l'étranglement thermique tout en maintenant des cycles d'entraînement ininterrompus de plusieurs mois.
L'ergonomie de la distribution électrique est tout aussi redoutable. L'exploitation de 5 000 racks denses exige une infrastructure de sous-station dédiée à l'échelle du mégawatt, des systèmes de stockage d'énergie par batterie (BESS) robustes pour la stabilisation du réseau, et des alimentations sans coupure (UPS) redondantes pour atténuer les micro-pannes qui pourraient autrement corrompre les états de point de contrôle actifs pendant les entraînements de modèles massifs. Les gains d'efficacité offerts par les nœuds de lithographie avancés de l'architecture Rubin sont cruciaux ici ; sans améliorations spectaculaires des performances par watt, la consommation électrique pure de la mise à l'échelle à 360 000 unités dépasserait les limites pratiques d'interconnexion au réseau des corridors de centres de données standard, forçant les hyper-scalers à se co-localiser à proximité de sources de production d'énergie dédiées.
Le verdict définitif
La poursuite calculée par SpaceX et xAI d'un plan de dette de 40 milliards de dollars pour le matériel Nvidia Rubin est une masterclass à enjeux élevés et à forte intensité de capital en matière de domination de l'infrastructure. Financièrement, tirer parti de la dette de qualité investissement via des institutions comme Apollo et Pimco permet à l'entreprise de sécuriser un calcul générationnel sans diluer les capitaux propres prématurément. Technologiquement, le déploiement d'environ 5 000 systèmes Vera Rubin NVL72 positionne xAI à la frontière absolue de la capacité mondiale en intelligence artificielle, fournissant les FLOPS bruts et la bande passante mémoire nécessaires pour devancer les concurrents limités par des modèles de dépenses en capital conventionnels.
Recommandation finale : Pour les analystes institutionnels comme pour les ingénieurs matériels, cette décision signale que la course à l'infrastructure IA est entrée dans une phase à l'échelle industrielle où l'accès aux marchés de la dette et au silicium avancé dictent le leadership du marché. Bien que l'exposition financière soit stupéfiante, les dividendes technologiques liés à la sécurisation de 360 000 accélérateurs Rubin garantissent que le fossé de calcul de xAI restera pratiquement impénétrable jusqu'à la fin des années 2020.