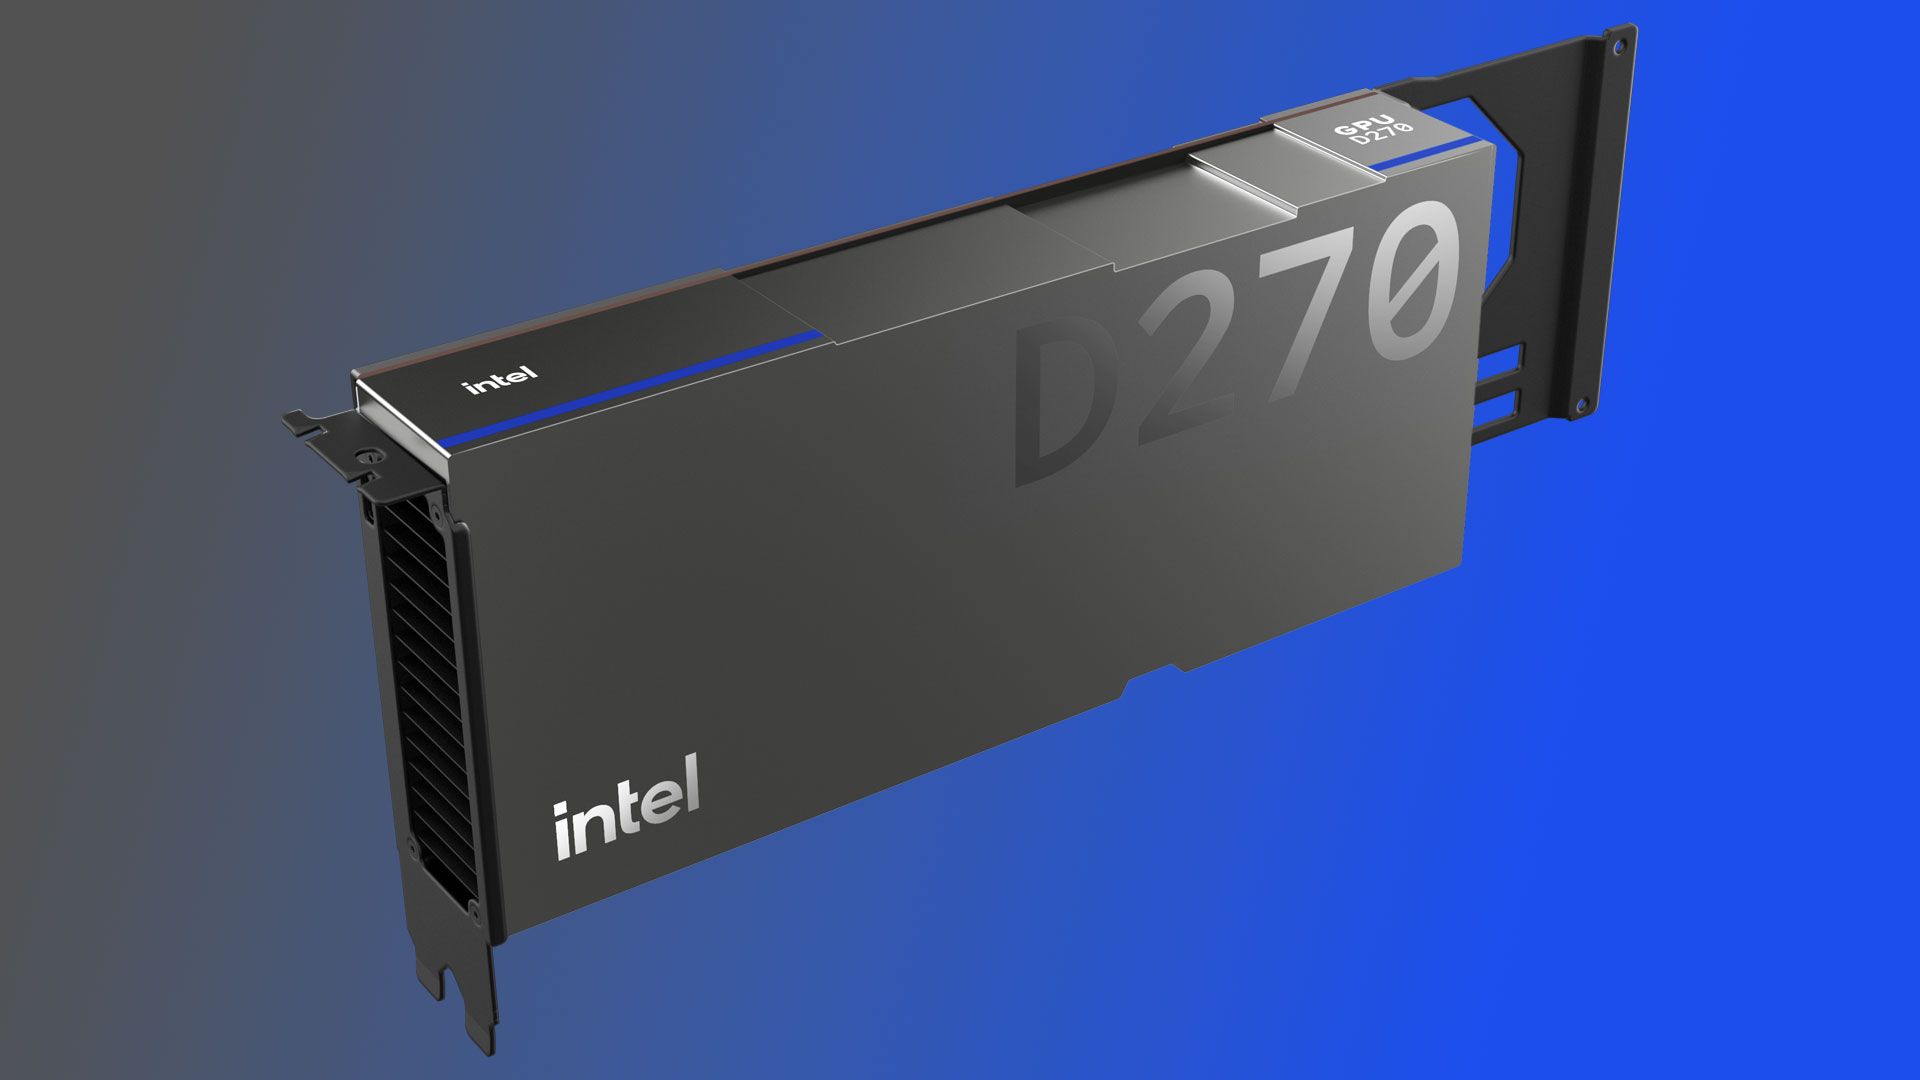
Résumé exécutif et positionnement sur le marché
Le dévoilement officiel par Intel de la série GPU D — anciennement connue sous le nom de code « Crescent Island » — représente un pivot stratégique majeur pour les ambitions de l'entreprise dans le domaine des centres de données. Après les performances mitigées du GPU Data Center Max (Ponte Vecchio) et la dissolution ultérieure de ses feuilles de route plus larges pour les accélérateurs haut de gamme, la série GPU D marque une rupture avec la concurrence directe contre les fleurons ultra-haut de gamme H100/Rubin de Nvidia. Au lieu de cela, Intel positionne ce silicium comme une bête de course refroidie par air et optimisée pour l'inférence, ciblant le vaste marché mal desservi des serveurs en rack d'entreprise qui manquent d'infrastructure pour des densités thermiques refroidies par liquide de plusieurs kilowatts par GPU.
La série D est, de fait, une reconnaissance que le chemin vers la pertinence sur le marché réside dans l'accessibilité et le pragmatisme thermique plutôt que dans la performance pure d'une puce unique. En privilégiant un TDP de 350W et des formats PCIe traditionnels, Intel courtise la vaste population d'infrastructures d'IA héritées et de génération actuelle. Il s'agit d'une stratégie de base, visant à fournir une solution cohérente et évolutive pour l'inférence multi-locataires, la robotique et les tâches d'IA en périphérie, où le rapport puissance par watt et la simplicité opérationnelle priment sur le débit d'entraînement maximal.
Innovations architecturales et technologiques fondamentales
Au cœur de la série D se trouve l'architecture Xe3P, une dérivation spécialisée de la base graphique d'Intel, débarrassée des pipelines de rastérisation et de géométrie traditionnels. Il ne s'agit pas d'un GPU au sens conventionnel, mais plutôt d'un moteur de calcul massivement parallèle conçu spécifiquement pour la nature intensive en données de l'inférence. L'accent est mis ici sur un débit à haute bande passante, mis en évidence par la bande passante mémoire de 1,5 To/s, essentielle pour éviter les goulots d'étranglement inhérents au chargement de modèles à grands paramètres dans les tampons locaux lors de sessions d'inférence simultanées.
L'engagement d'Intel envers la « base logicielle commune Xe » est la clé du succès de ce matériel. Historiquement, le talon d'Achille des efforts d'accélérateurs discrets d'Intel a été le décalage entre la capacité du silicium et la maturité logicielle. En ancrant la série D à un écosystème logiciel établi qui imprègne ses offres intégrées et discrètes mobiles/bureau, Intel tente d'abaisser la barrière à l'entrée pour les développeurs. L'objectif est d'offrir une transition transparente pour les modèles optimisés pour les plateformes mobiles basées sur Xe afin qu'ils soient déployés à grande échelle sur les racks de la série D, créant ainsi un chemin de déploiement d'IA unifié, de la périphérie au centre de données.
Spécifications empiriques et matrice de référence
| Spécification | Intel GPU série D | Nvidia Rubin (Est. par GPU) | Segment de marché |
|---|---|---|---|
| Architecture | Xe3P | Vera Rubin | Inférence/Entraînement |
| Performance FP8 crête | 1,3 PFLOPS | 17,5 PFLOPS | Mise à l'échelle |
| Bande passante mémoire | 1,5 To/s | N/A (HBM4) | Débit |
| TDP | 350W | 1000W+ | Enveloppe thermique |
| Refroidissement | Air | Liquide | Infrastructure |
Thermique, efficacité et ergonomie réelle
En limitant la série GPU D à 350W, Intel a effectivement contourné l'obstacle le plus important pour de nombreux clients entreprises : les rénovations pour le refroidissement liquide. Dans le centre de données moderne, le coût d'installation d'une infrastructure de refroidissement avancée pour un petit cluster de serveurs IA est souvent prohibitif. La série D offre une capacité « plug-and-play » pour les environnements de rack refroidis par air existants, permettant aux entreprises de faire évoluer leur capacité d'inférence jusqu'à huit GPU par nœud sans déclencher une refonte massive de leurs systèmes d'alimentation ou de refroidissement.
De plus, l'intégration jusqu'à 480 Go de mémoire LPDDR5X répond à la demande de prise en charge des modèles à grands paramètres dans un encombrement compact. Bien que la LPDDR5X sacrifie une certaine vitesse absolue par rapport à la HBM3/4, son efficacité et son profil de coût sont idéaux pour l'inférence à long contexte et les services multi-locataires. Cela garantit que la série D reste viable pour les applications à longue traîne sensibles à la latence, où l'objectif est de maximiser le nombre de requêtes utilisateur simultanées plutôt que de pousser un modèle massif à terminer une époque d'entraînement en un temps record.
Le verdict définitif
La série GPU D d'Intel est un produit calculé et réaliste qui s'aligne sur l'état actuel de l'industrie : un besoin désespéré de matériel d'inférence efficace et accessible. Ce n'est pas un « tueur de Nvidia » au sens de la performance pure, et il n'aspire pas à l'être. Au contraire, c'est une pièce essentielle du puzzle pour les entreprises qui ne peuvent pas, ou ne veulent pas, adopter les exigences extrêmes de refroidissement liquide des puces d'IA phares actuelles. À condition que la pile de pilotes et l'écosystème logiciel d'Intel tiennent la route lors d'un déploiement réel, la série D pourrait être l'accélérateur le plus pragmatique de l'histoire récente de l'entreprise. Pour les organisations privilégiant l'échelle d'inférence et le coût opérationnel, la série D est fortement recommandée comme candidat principal au déploiement.