Résumé analytique et positionnement sur le marché
Le paysage des accélérateurs d'intelligence artificielle a radicalement changé suite à la transaction structurellement unique de 20 milliards de dollars de Nvidia impliquant Groq, l'architecte pionnier des unités de traitement du langage (LPU). Plutôt que de procéder à un rachat d'entreprise traditionnel à grande échelle, Nvidia a structuré un accord hybride comprenant 17 milliards de dollars de frais de licence pour la propriété intellectuelle fondamentale de Groq, parallèlement à un fonds d'actions de 3 milliards de dollars destiné aux quelque 200 ingénieurs passés directement dans la division matérielle de Nvidia. Cette manœuvre non conventionnelle — qualifiée de « rachat inversé » par les organismes de réglementation — a déclenché un examen minutieux, aboutissant à un recours collectif proposé devant la Cour de chancellerie du Delaware par les anciens ingénieurs de Groq, Benjamin Serebrin et Joshua Rubin. Les plaignants allèguent que le conseil d'administration a favorisé certains investisseurs en capital-risque tout en lésant les actionnaires généraux, une controverse aggravée par les enquêtes actives du ministère de la Justice et de la Commission fédérale du commerce.
Du point de vue du positionnement sur le marché, l'accord permet à Nvidia d'intégrer une technologie d'inférence déterministe à ultra-faible latence directement dans ses stratégies de déploiement de centres de données haut de gamme. Les dépôts 10-K de Nvidia auprès de la SEC révèlent qu'environ 14,4 milliards de dollars du capital de licence ont été comptabilisés en goodwill, explicitement liés à la main-d'œuvre spécialisée et au développement technologique tourné vers l'avenir, ne laissant que 2,5 milliards de dollars affectés directement aux conceptions matérielles fondamentales. Pendant ce temps, l'entité résiduelle de Groq s'est orientée agressivement vers les services d'IA basés sur le cloud, exploitant des centres de données et déployant ses propres technologies sous le nouveau cadre Nvidia Groq 3 LPX. Cette manœuvre juridique et commerciale à enjeux élevés redéfinit la manière dont les entreprises pesant des milliers de milliards de dollars acquièrent des talents en ingénierie et contournent les canaux traditionnels d'examen antitrust, tout en consolidant des architectures en silicium construites spécifiquement pour les phases de décodage des grands modèles de langage (LLM) à grande échelle.
Innovations architecturales et technologiques de base
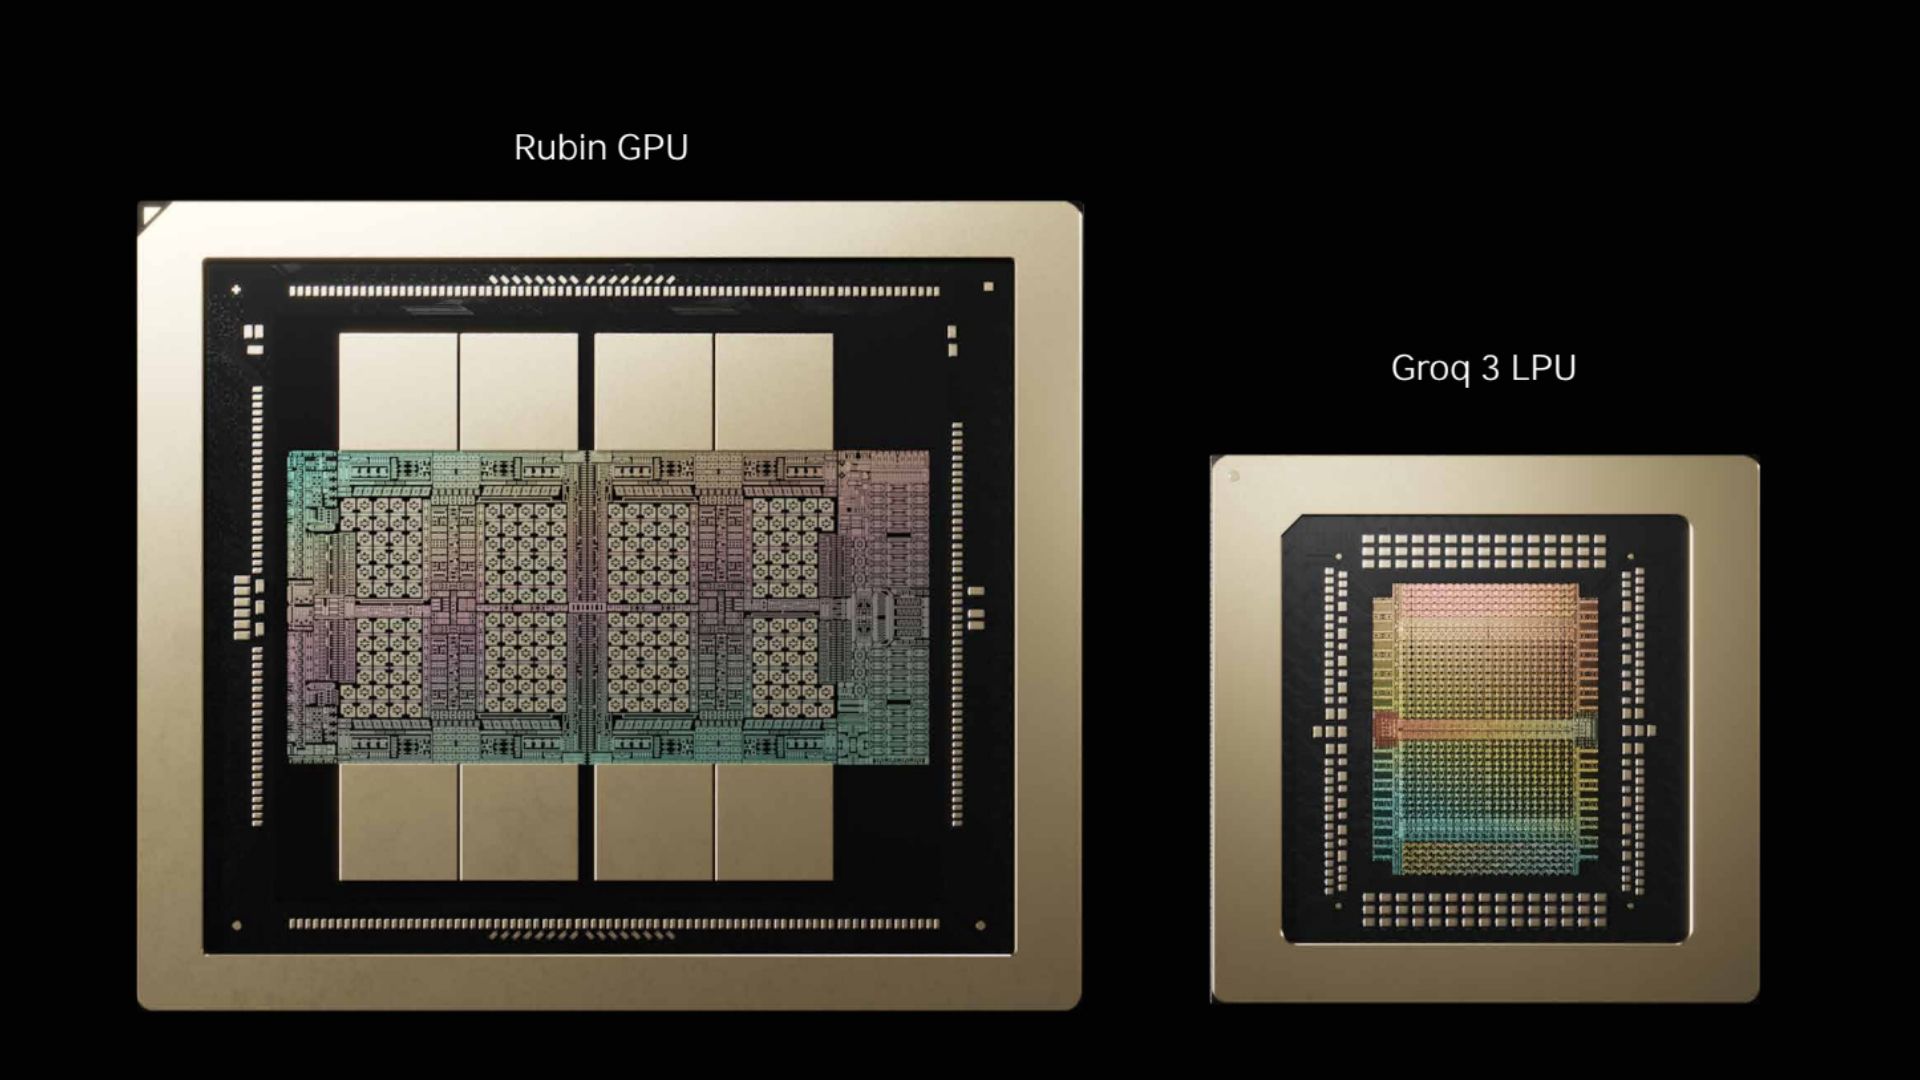
Au niveau du silicium, le fruit de cette transaction se manifeste dans le Groq LP30, un moteur d'inférence révolutionnaire construit sur la technologie de processus avancée 4nm (SF4X) de Samsung. S'écartant fondamentalement des architectures GPU traditionnelles qui reposent fortement sur des hiérarchies de mise en cache complexes et une planification dynamique, l'architecture Tensor Streaming de Groq exploite un modèle d'exécution déterministe défini par logiciel. Chaque puce LP30 embarque une SRAM haute bande passante impressionnante de 500 Mo directement sur puce, permettant une bande passante mémoire agrégée massive de 150 To/s par puce. Cette philosophie de conception élimine le goulot d'étranglement de von Neumann inhérent aux cycles de récupération HBM hors puce, faisant du LPU un coprocesseur de décodage exceptionnellement efficace lorsqu'il est associé à la prochaine infrastructure Vera Rubin NVL72 de Nvidia.
En faisant passer ce silicium au niveau du système, le rack Nvidia Groq 3 LPX consolide 256 LPU individuels en un seul nœud de calcul dense. Cette architecture collective génère 128 Go de SRAM distribuée ultra-rapide sur puce, une bande passante d'interconnexion interne stupéfiante de 40 Po/s et une performance globale évaluée à 315 FP8 PFLOPS. En fonctionnant comme un coprocesseur de décodage spécialisé, l'architecture LPX décharge les phases de génération de jetons liées à la mémoire des cœurs tensoriels primaires, accélérant considérablement le temps jusqu'au premier jeton et le débit de génération de jetons pour les charges de travail d'IA générative massives. Les futures itérations de la feuille de route, telles que le LP35 avec prise en charge native du NVFP4 et le LP40 ultérieur conçu pour les systèmes de génération Feynman, signalent que Nvidia a l'intention d'institutionnaliser profondément ce modèle d'exécution déterministe dans l'ensemble de sa pile de centres de données multi-générationnelle.
Spécifications empiriques et matrice de référence
| Paramètre architectural | Rack Groq LP30 / LPX | Nœud d'inférence GPU de référence (H100/B200) | Avantage / Compromis |
|---|---|---|---|
| Nœud de processus | Samsung 4nm (SF4X) | TSMC 4N / classe 3nm | Densité de transistors plus élevée vs écosystème de fonderie mature |
| Mémoire sur puce (SRAM) | 500 Mo par puce / 128 Go par rack | Cache L2 limité (~50 Mo - 100 Mo) | Capacité de bloc-notes déterministe massive |
| Mémoire hors puce | Centrée sur la SRAM (aucune dépendance HBM) | HBM3e / HBM4 (jusqu'à 8 To/s par GPU) | Élimine les pénalités de latence hors puce pour l'inférence |
| Bande passante globale | 150 To/s (par puce) / 40 Po/s (rack) | ~8 To/s par nœud accélérateur | Débit de génération de jetons sans précédent |
| Performance de calcul | 1,23 FP8 PFLOPS (LPU unique) | Débit variable des cœurs tensoriels FP8 | Optimisé explicitement pour les étapes de décodage déterministes |
Thermique, efficacité et ergonomie réelle
L'intégration de 256 LPU aux côtés de réseaux SRAM massifs dans un encombrement de rack de serveur standard introduit de graves problèmes de densité thermique. Contrairement aux clusters GPU traditionnels où la dissipation thermique est dominée par des piles HBM haute puissance et des puces de calcul monolithiques massives, l'architecture Groq LPX répartit les charges thermiques sur de nombreuses puces plus petites, à haute fréquence et riches en SRAM, construites sur le nœud 4nm de Samsung. Ce profil thermique distribué nécessite une intégration de refroidissement liquide sur mesure pour maintenir des températures de jonction optimales, en particulier lors de l'exploitation dans des centres de données denses de 200+ MW vers lesquels Groq et ses partenaires cloud se dirigent actuellement.
Du point de vue de l'efficacité, l'omission d'interfaces mémoire hors puce gourmandes en énergie (telles que le HBM multi-piles) génère des gains d'efficacité substantiels pendant la phase de génération de jetons autorégressive. En maintenant les ensembles de travail actifs entièrement dans la limite de 128 Go de SRAM agrégée d'un rack de 256 LPU, la consommation d'énergie dynamique par jeton généré chute précipitamment par rapport aux architectures traditionnelles qui récupèrent à plusieurs reprises les poids de la DRAM externe. Les benchmarks de déploiement réels soulignent que ce pipeline déterministe minimise les latences de queue, garantissant des SLA opérationnels prévisibles pour les fournisseurs de cloud d'IA d'entreprise comme Nebius et les partenaires d'intégration Dell qui déploient des clusters d'inférence de production.
Le verdict définitif
La transaction de 20 milliards de dollars de Nvidia avec Groq constitue un modèle d'acquisition d'ingénierie d'entreprise moderne, contournant avec succès les blocages de fusion standard tout en capturant les meilleurs talents et la propriété intellectuelle en matière de LPU déterministe de l'industrie. Sur le plan architectural, la plate-forme Groq 3 LPX résultante et son silicium LP30 sous-jacent représentent un bond monumental dans l'efficacité de la génération de jetons autorégressifs, prouvant que les modèles d'exécution centrés sur la SRAM et définis par logiciel jouent un rôle permanent et critique dans les déploiements d'IA hyperscale de nouvelle génération. Cependant, l'ombre des enquêtes actives du ministère de la Justice et des litiges non résolus des actionnaires dans le Delaware injecte une volatilité réglementaire persistante dans l'horizon commercial à long terme du matériel. Pour les acheteurs d'entreprise et les architectes cloud, les performances matérielles sont indéniablement d'élite ; pour le marché plus large des semi-conducteurs, cet accord établit un précédent litigieux qui remodèlera définitivement la manière dont la propriété intellectuelle et les équipes d'ingénierie d'élite sont acquises.