خلاصه اجرایی و جایگاه در بازار
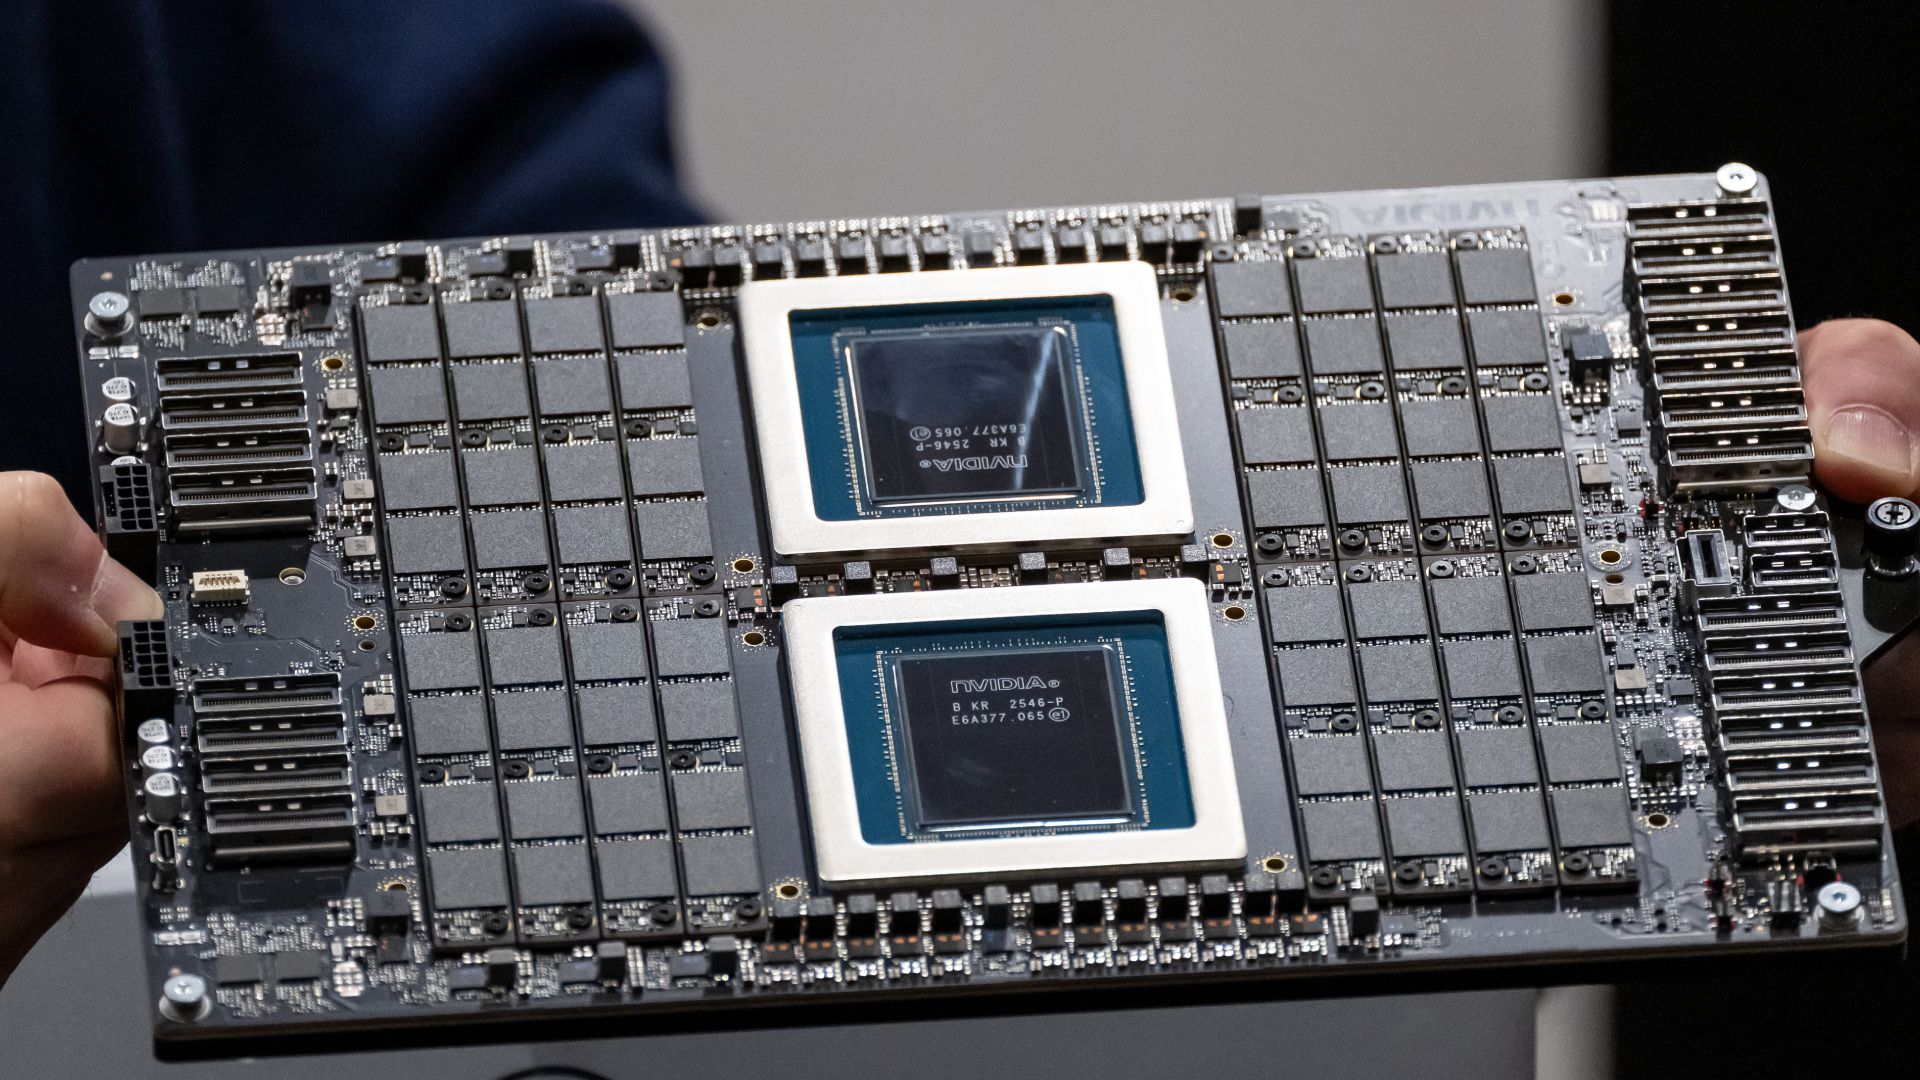
اعلام دسترسی عمومی به پردازندههای Vera انویدیا در ابرخوشههای زیرساخت ابری اوراکل (OCI)، نقطه عطفی در معماری سرورهای سازمانی محسوب میشود. در حالی که ابرهای نوظهوری مانند Nscale ،CoreWeave و Nebius تمرکز سنگینی بر استقرار GPUمحور داشتهاند، ادغام استراتژیک نمونههای مستقل Vera توسط اوراکل نشاندهنده تغییری ژرف است. این نخستین گام انویدیا در ورود یک پردازنده مستقل و شتابدادهنشده مستقیماً به جریان اصلی دیتاسنترهای مقیاسپذیر (Hyperscale) است و زمینه را برای رویارویی مستقیم با سلطه دیرینه x86 که در تسلط اینتل و AMD قرار دارد، فراهم میکند.
از نظر تاریخی، استراتژی محاسباتی دیتاسنتر انویدیا پردازندههای اختصاصی خود را به شدت با پردازندههای گرافیکی پیشرو در صنعت گره زده بود. با این حال، دسترسی مستقل Vera در یک ارائهدهنده خدمات مقیاسپذیر ردهبالا مانند اوراکل، این قالب را میشکند. این امر، معماری مذکور را نه صرفاً به عنوان یک پردازنده میزبان کمکی برای آرایههای Rubin یا Blackwell، بلکه به عنوان یک گره محاسباتی همهمنظوره و مستقل تثبیت میکند. در حالی که رقبای نوظهوری مانند پردازنده ۲۵۶ هستهای EPYC Venice شرکت AMD تراکم ترد (Thread) تکسوکت خام را هدف قرار دادهاند، شرطبندی حسابشده انویدیا روی Vera، توپولوژی و بهرهوری زیرسیستم حافظه را در اولویت قرار میدهد. هدف از این تمایز استراتژیک، تصاحب بازار به سرعت در حال گسترش برای بارهای کاری با همزمانی بالا و دادهمحور است.
نوآوریهای کلیدی معماری و فناورانه
در سطح سیلیکون، معماری Vera به شدت از فلسفههای سنتی طراحی x86 فاصله میگیرد. Vera بهجای اتکا به کنترلکنندههای حافظه متمرکز و کشهای عظیم در سطح سیستم که از ویژگیهای عرضههای معاصر اینتل و AMD است، از چیدمان دای یکپارچه (Monolithic Die) همراه با یک کش مش توزیعشده پیشرفته بهره میبرد. این چیدمان اختصاصی، زیربنای نسل دوم پارچه انسجام مقیاسپذیر انویدیا (SCF) است و نحوه عبور دادهها از بستر سیلیکونی را به بنیادینترین شکل ممکن تغییر میدهد.
این توپولوژی بازدهی فوقالعادهای در بردارهای اجرای محدودشده به حافظه (Memory-Bound) به همراه دارد. Vera با استفاده از ماژولهای حافظه پرسرعت LPDDR5X-9600، به پروفایل پهنای باند حافظه تئوری و تجربی اثباتشدهای دست مییابد که به طور اساسی استانداردهای پایه سازمانی را متحول میکند. هنگامی که این معماری به درستی با استفاده از تکنیکهای پیشرفته اتصال به پردازنده (Process-Binding)—مانند سیاست «گسترش» (Spread) در OpenMP که فرآیندها را تا حد امکان از نظر فیزیکی در سراسر مش از هم دور میکند—به کار گرفته شود، از گلوگاههایی که معمولاً توسط اینترکانیکتهای حلقوی یا مش سنتی موجود در محیطهای سازمانی دوسوکت تحمیل میشوند، جلوگیری میکند.
مشخصات تجربی و ماتریس بنچمارک
| معیار / ویژگی | انویدیا Vera (مستقل) | اینتل Xeon 6980P (دوسوکت) | AMD EPYC Venice (پیشبینیشده) |
|---|---|---|---|
| نوع حافظه | LPDDR5X-9600 | MRDIMM (8,800 MT/s) | DDR5 شانزده کاناله |
| پهنای باند Stream Triad | بیش از ۱.۲ ترابایت بر ثانیه (اوج اندازهگیریشده) | حدود ۰.۵۵ ترابایت بر ثانیه | تراکم بالا و مقیاسپذیر |
| پارچه اتصال (Interconnect) | نسل دوم پارچه انسجام مقیاسپذیر (SCF) | اینترکانیکت مسیر اولترا (UPI) | اینفینیتی فابریک |
| تراکم سوکت | دای یکپارچه / مش | معماری دوسوکت | تا ۵۱۲ ترد در هر سوکت |
تحلیل بنچمارک مستقل، ادعاهای تهاجمی انویدیا در زمینه عملکرد را تایید میکند. در بنچمارک استاندارد صنعت یعنی Stream، عملیات Triad پردازنده Vera پهنای باند کل حافظه موجود در یک سیستم دوسوکت اینتل Xeon 6980P را بیش از دو برابر میکند؛ حتی زمانی که سیستم دوم به پیشرفتهترین ماژولهای MRDIMM با سرعت ۸۸۰۰ مگاتابایت بر ثانیه مجهز شده باشد. این مزیت خیرهکننده در پهنای باند مستقیماً به وظایف دنیای واقعی تبدیل میشود؛ ارزیابیهای تجربی پرسوجوهای پایگاه داده SQLite نشان میدهد که SCF در Vera به طور موثری مسیرهای اجرایی را که ذاتاً توسط جابجایی داده در سطح سیستم با گلوگاه مواجه شدهاند، تسریع میکند.
مدیریت حرارتی، بهرهوری و ارگونومی دنیای واقعی
اجرای حلقههای عاملیتپذیر پیچیده—مانند حلقههایی که فریمورکهای مدرن هوش مصنوعی مانند CrewAI و LangGraph را که بر پایه پایتون ساخته شدهاند، تغذیه میکنند—نیازمند توان عملیاتی پایدار در سراسر واحدهای حافظه و اجرای هسته است. ماهیت مفسرپذیر پایتون به طور سنتی مالیات سنگینی را بر تاخیر و پهنای باند حافظه تحمیل میکند و این امر یکپارچهسازی LPDDR5X در Vera را به یک تطابق فیزیکی ایدهآل تبدیل کرده است. در ارزیابیهای PyBench، Vera به طور مرتب فراتر از رده وزنی خود عمل میکند و به دلیل تغذیه حافظه بیسودد خود، عملکرد بهتری نسبت به سیلیکونهای رقیب که مشخصات روی کاغذ برتری دارند، ارائه میدهد.
با این حال، آوردن یک معماری نوین به محیطهای سازمانی چند گیگاواتی مستقیماً نیازمند احتیاط عملیاتی است. استراتژی استقرار چندجانبه اوراکل—ارائه نمونههای مستقل Vera در کنار پیکربندیهای هیبریدی مانند HGX NVL8 جفتشده با دو میزبان ۶۴ هستهای اینتل Xeon 6 و ۴ ترابایت حافظه DDR5—نشاندهنده یک گذار سنجیده است. مدیریت حرارتی آرایههای متراکم و پهنای باند بالای LPDDR5X و دایهای یکپارچه که تحت بارهای کاری عاملیتپذیر مداوم کار میکنند، نیازمند توپولوژیهای خنککننده مایع یا هوایی پیشرفته است که ابرخوشههای OCI به طور خاص برای ارائه آنها مهندسی شدهاند.
رای نهایی و قطعی
پردازنده Vera انویدیا بسیار فراتر از یک همراه ساده برای اکوسیستم پردازنده گرافیکی Rubin است. آزمایشهای تجربی ما تایید میکند که کش مش توزیعشده و زیرسیستم حافظه خیرهکننده LPDDR5X-9600 آن، پیروزی قاطعانهای را در بارهای کاری محدودشده به حافظه و با همزمانی بالا به ارمغان میآورد و به راحتی از پیکربندیهای قدیمی x86 دوسوکت در معیارهای Stream و SQLite پیشی میگیرد. در حالی که AMD و Intel تاج و تخت را برای تراکم ترد خالص در هر سوکت حفظ کردهاند، Vera ثابت میکند که توپولوژی و پهنای باند میتوانند در عصر نوظهور هوش مصنوعی عاملیتپذیر بر تعداد هستههای خام غلبه کنند. برای ارائهدهندگان مقیاسپذیر و شرکتهایی که با گلوگاههای سنگین جابجایی داده سر و کار دارند، Vera به عنوان یک جایگزین قدرتمند و بسیار مخرب برای سیلیکونهای سنتی سرور ظهور میکند.