خلاصه اجرایی و جایگاه بازار
گزارشهای مالی اخیر حاکی از آن است که اسپیساکس در حال مهندسی فعالانه یک بسته بدهی عظیم ۴۰ میلیارد دلاری برای سال ۲۰۲۷ است که عمدتاً برای تهیه پردازندههای هوش مصنوعی نسل بعدی انویدیا طراحی شده است. اگرچه ساختارهای شرکتی بهطور رسمی این ابتکار را از طریق اکوسیستم گستردهتر ایلان ماسک هدایت میکنند، اما بهرهبرداری عملیاتی آن، خوشههای پردازشی در مقیاس بسیار بزرگ (Hyper-scale) شرکت xAI را هدف قرار میدهد. گفته میشود این ابزار مالی پیشنهادی، ترکیبی از ۱۰ میلیارد دلار وام مستقیم بانکی و ۳۰ میلیارد دلار بدهی با رتبه سرمایهگذاری است که شایعه شده غولهای مالی مانند «آپولو گلوبال منیجمنت» و «پیمکو» مدیریت ساختار آن را بر عهده دارند. این تزریق سرمایه بیسابقه، نشاندهنده تغییری بنیادی در نحوه تأمین زیرساختهای فوقسریع است که از مرز سرمایهگذاریهای خطرپذیر سنتی و جریانهای نقدی شرکتی فراتر رفته و به ابزارهای بدهی در مقیاس حاکمیتی تبدیل شده است.
از دیدگاه جایگاه بازار، این هزینه، سوابق تاریخی چرخههای تأمین سختافزار برای یک نهاد واحد را در هم میشکند. با تکیه بر استقرارهای قبلی xAI—مانند تکرارهای خوشه «کولوسوس» که از صدها هزار شتابدهنده با معماری «بلکول» بهره میبرد—زمانبندی استقرار در سال ۲۰۲۷ مستقیماً با نسل آینده «ورا روبین» انویدیا مطابقت دارد. با قفل کردن میلیاردها دلار بودجه اختصاصی سختافزار از سالها قبل، xAI در تلاش است تا از کمبود جهانی سیلیکون پیشی بگیرد، تخصیصهای ریختهگری (Foundry) تراز اول را تضمین کند و مسیر تهاجمی خود را در مسابقه تسلیحاتی مدلهای بنیادی هوش مصنوعی مولد حفظ کند. این استراتژی با سیلیکون پیشرفته نه صرفاً به عنوان یک هزینه سرمایهای، بلکه به عنوان یک دارایی استراتژیک اولیه قابل مقایسه با زیرساختهای سنگین صنعتی برخورد میکند.
نوآوریهای معماری و فناورانه اصلی
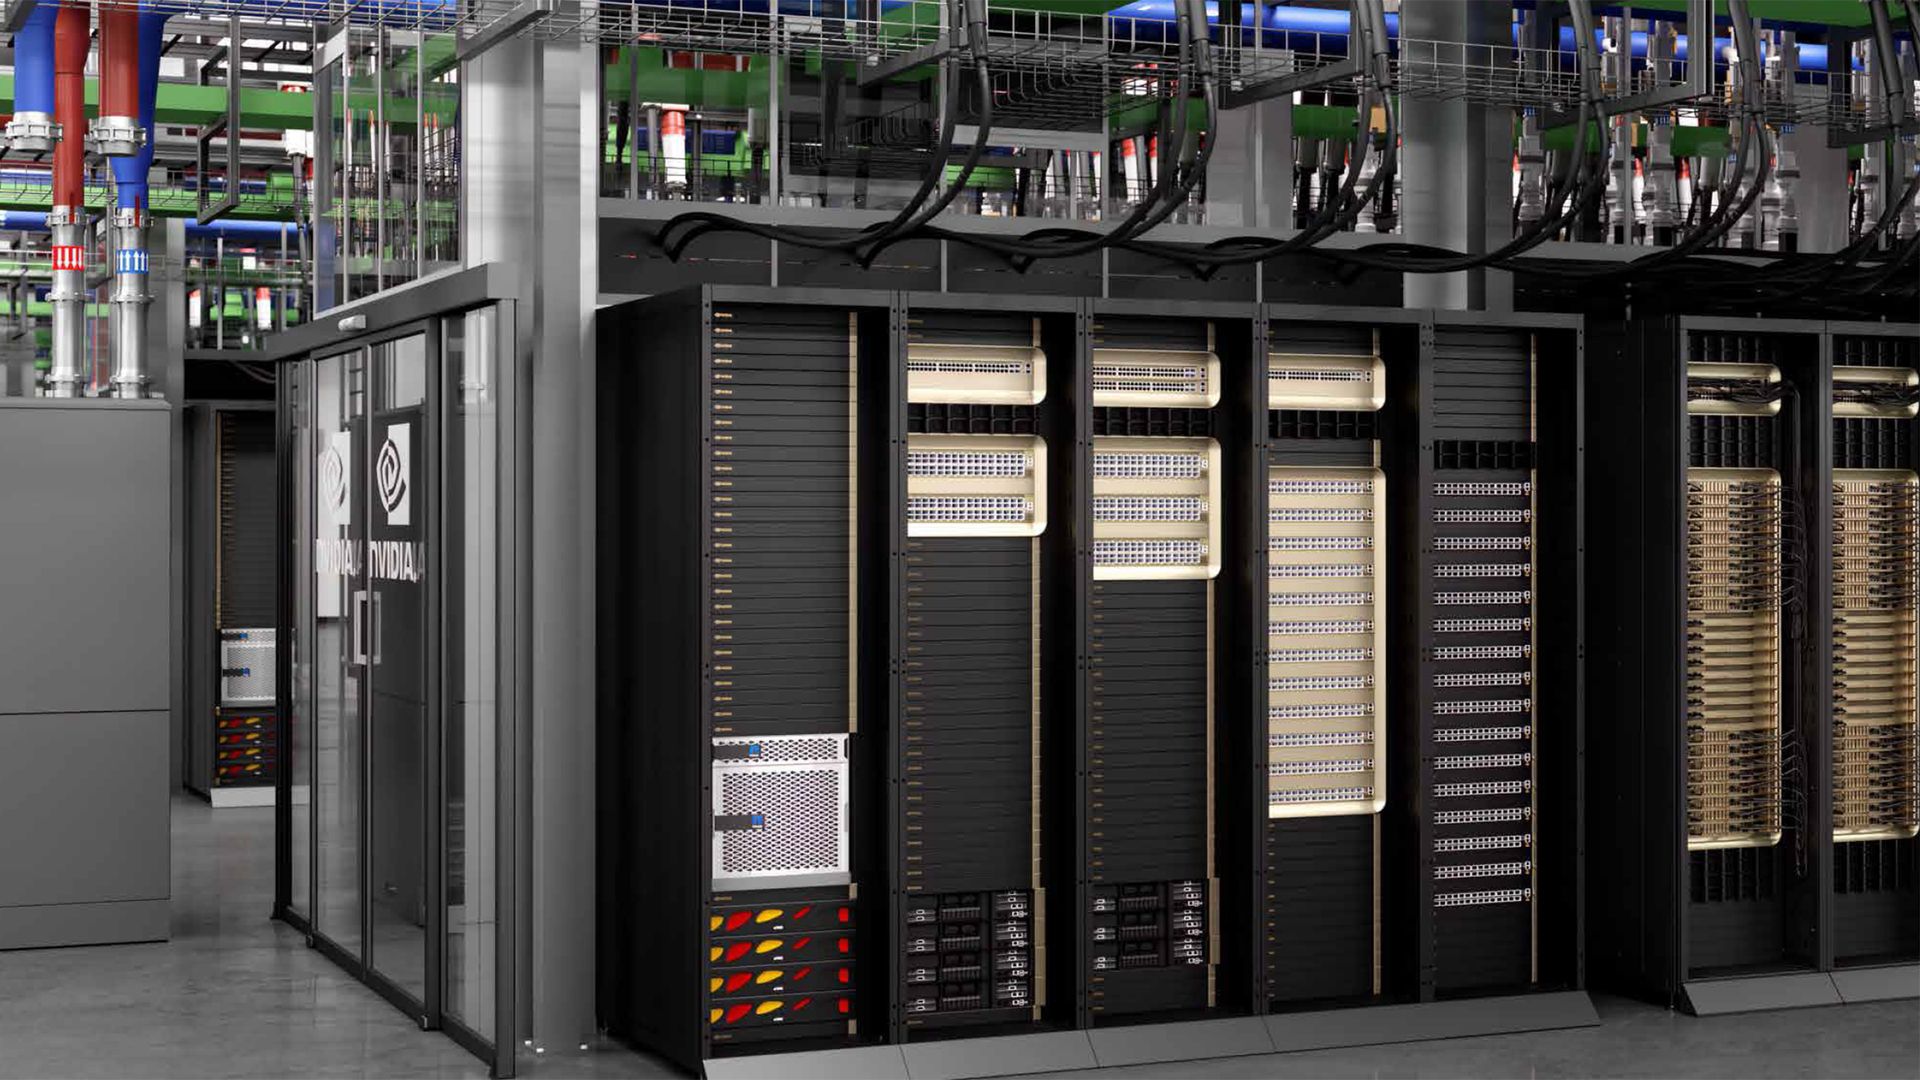
لنگرگاه فناورانه این هزینه ۴۰ میلیارد دلاری پیشبینیشده، معماری آتی «ورا روبین» انویدیا است که بهطور خاص انتظار میرود در پیکربندیهای قفسهای (Rack-scale) مشابه «روبین NVL72» مستقر شود. نسل روبین با عبور از پارادایمهای معماری «هاپر» و «بلکول»، تغییرات گستردهای را در نسبت محاسبات به حافظه، یکپارچهسازی اتصالات نوری و ساختارهای سوئیچ اختصاصی NVLink معرفی میکند. با توجه به ارزشگذاریهای نجومی واحدهای قفسهای منفرد—که حدود ۸.۸ میلیون دلار برای هر مجموعه NVL72 برآورد میشود—این سختافزار نشاندهنده لبه مطلق محاسبات ناهمگون متراکم است. هر قفسه شامل پردازندههای سفارشی، حافظه با پهنای باند بالا (HBM4) و سیلیکونهای همطراحیشده است که برای بارهای کاری سنگین استنتاج و آموزش مبتنی بر ترنسفورمر بهینهسازی شدهاند.
در مقیاس کلان، تخصیص ۴۰ میلیارد دلار به اکوسیستم «روبین NVL72» به معنای حدود ۵,۰۰۰ سیستم قفسهای کاملاً یکپارچه است که تقریباً ۳۶۰,۰۰۰ شتابدهنده هوش مصنوعی روبین انویدیا را در خود جای میدهند. این چگالی، الزامات توپولوژی مرکز داده را بهطور اساسی تغییر میدهد. برخلاف استقرارهای سرور سنتی که در آن گرهها بهصورت افزایشی از مادربردها و کارتهای رابط مجزا مونتاژ میشوند، رویکرد قفسهای روبین با کل شاسی ۷۲-GPU به عنوان یک موتور محاسباتی یکپارچه برخورد میکند. این امر گلوگاههای تأخیر را به حداقل میرساند، پهنای باند درونقفسهای را از طریق آرایههای فرستنده-گیرنده نوری چند ترابیتی به حداکثر میرساند و ارکستراسیون پیچیده مورد نیاز برای آموزش مدلهای بنیادی کلاس پیشرو را بدون مواجهه با محدودیتهای شبکهای تسهیل میکند.
مشخصات تجربی و ماتریس معیار
| شاخص سختافزاری | انویدیا Blackwell GB200 (مبنا) | انویدیا Vera Rubin NVL72 (پیشبینی) | تفاوت معماری |
|---|---|---|---|
| گره پردازشی | TSMC 4NP سفارشی | کلاس پیشرفته N3 / N2 | چگالی ترانزیستوری بالاتر و نشت کمتر |
| استاندارد حافظه | HBM3e (تا ۱۹۲ گیگابایت در بسته) | HBM4 (ظرفیت و عرض باس گسترده) | افزایش نمایی پهنای باند حافظه |
| پهنای باند اتصال | ۱.۸ ترابایت بر ثانیه دوطرفه هر GPU | نسل بعدی سوئیچ NVLink | تأخیر کمتر، کارایی مقیاسگذاری بالاتر |
| هزینه تقریبی واحد | ~۳ تا ۴ میلیون دلار معادل هر قفسه | ~۸.۸ میلیون دلار برای هر قفسه NVL72 | بازتابدهنده مقیاس یکپارچگی و صرفه HBM4 |
| هدف استقرار | ۲۰۲۴–۲۰۲۵ (تکرارهای کولوسوس) | ۲۰۲۷ (پنجره هدف xAI) | قابلیت آموزش پیشرو نسل بعدی |
حرارت، کارایی و ارگونومی دنیای واقعی
استقرار تقریباً ۳۶۰,۰۰۰ شتابدهنده روبین در ۵,۰۰۰ واحد قفسهای، چالشهای بیسابقهای در مهندسی تأسیسات و ترمودینامیک ایجاد میکند. با توجه به اینکه چگالی توان هر قفسه از ۱۰۰ کیلووات فراتر رفته و بسته به تنظیم کلاک و شدت بار کاری ممکن است به آستانه ۱۵۰ کیلووات نزدیک شود، خنککنندههای هوا برای این کلاس از سختافزار کاملاً منسوخ شدهاند. تأسیسات میزبان xAI کاملاً به حلقههای خنککننده پیشرفته مایع به تراشه، منیفولدهای دقیق توزیع خنککننده (CDMs) و مبدلهای حرارتی حلقه ثانویه با ظرفیت بالا متکی خواهند بود. مدیریت حرارتی باید دمای محل اتصال را در حد سختگیرانهای نگه دارد تا از کاهش عملکرد حرارتی (Thermal Throttling) جلوگیری کند و در عین حال، اجرای آموزشهای بدون وقفه در چندین ماه را حفظ کند.
ارگونومی انتقال نیرو نیز به همان اندازه مهیب است. بهرهبرداری از ۵,۰۰۰ قفسه متراکم، نیازمند زیرساخت پست برق در مقیاس مگاوات، سیستمهای ذخیرهسازی انرژی باتری (BESS) برای تثبیت شبکه و منابع تغذیه بدون وقفه (UPS) برای کاهش قطعیهای لحظهای است که در غیر این صورت میتوانند وضعیتهای چکپوینت فعال را در طول آموزش مدلهای عظیم خراب کنند. در اینجا، افزایش کارایی حاصل از گرههای لیتوگرافی پیشرفته معماری روبین بسیار حیاتی است؛ بدون بهبود چشمگیر در عملکرد به ازای هر وات، مصرف برق خالص برای مقیاسگذاری به ۳۶۰,۰۰۰ واحد از محدودیتهای عملی اتصالات شبکه در راهروهای مراکز داده استاندارد فراتر میرود و فوقمقیاسگذاران را مجبور میکند تا در مجاورت منابع تولید برق اختصاصی مستقر شوند.
قضاوت نهایی
تلاش حسابشده اسپیساکس و xAI برای دریافت یک بسته بدهی ۴۰ میلیارد دلاری جهت خرید سختافزار روبین انویدیا، یک کلاس درس سرمایهبر و پرخطر در تسلط بر زیرساختها است. از نظر مالی، استفاده از بدهی با رتبه سرمایهگذاری از طریق نهادهایی مانند آپولو و پیمکو به این شرکت اجازه میدهد تا بدون رقیق کردن زودهنگام سهام، توان محاسباتی نسلی خود را تضمین کند. از نظر فناورانه، استقرار حدود ۵,۰۰۰ سیستم «ورا روبین NVL72» شرکت xAI را در لبه مطلق قابلیتهای هوش مصنوعی جهانی قرار میدهد و FLOPS خام و پهنای باند حافظه لازم برای پیشی گرفتن از رقبای محدود به مدلهای مرسوم مخارج سرمایهای را فراهم میکند.
توصیه نهایی: برای تحلیلگران نهادی و مهندسان سختافزار به طور یکسان، این حرکت نشان میدهد که مسابقه زیرساختهای هوش مصنوعی وارد مرحلهای در مقیاس صنعتی شده است که در آن دسترسی به بازارهای بدهی و سیلیکونهای پیشرفته در مقیاس قفسهای، تعیینکننده رهبری بازار است. اگرچه ریسک مالی بسیار تکاندهنده است، اما سودهای فناورانه حاصل از تأمین ۳۶۰,۰۰۰ شتابدهنده روبین تضمین میکند که خندق محاسباتی xAI تا اواخر دهه ۲۰۲۰ عملاً غیرقابل نفوذ باقی خواهد ماند.