خلاصه مدیریتی و جایگاهیابی در بازار
چشمانداز شتابدهندههای هوش مصنوعی پس از معامله ساختارمند ۲۰ میلیارد دلاری انویدیا با «گروک» (Groq)، پیشرو در طراحی واحدهای پردازش زبان (LPU)، دستخوش تغییری اساسی شد. انویدیا به جای اجرای یک خرید کامل و سنتی شرکتی، یک توافق ترکیبی شامل ۱۷ میلیارد دلار هزینه مجوز برای مالکیت معنوی اصلی گروک به همراه ۳ میلیارد دلار سهام اختصاصی برای حدود ۲۰۰ مهندسی که مستقیماً به بخش سختافزار انویدیا منتقل شدند، ساختاردهی کرد. این مانور غیرمتعارف - که توسط ناظران نظارتی «استخدام معکوس» نامیده شده - باعث بررسیهای دقیق و گستردهای شد که به طرح دعوی دسته جمعی در دادگاه دلاور توسط مهندسان سابق گروک، بنجامین سبرین و جاشوا روبین، انجامید. شاکیان ادعا میکنند که هیئت مدیره ضمن نادیده گرفتن سهامداران خرد، از سرمایهگذاران خطرپذیر خاصی حمایت کردهاند؛ جنجالی که با تحقیقات فعال وزارت دادگستری و کمیسیون تجارت فدرال پیچیدهتر نیز شده است.
از دیدگاه جایگاهیابی در بازار، این توافق به انویدیا اجازه میدهد فناوری استنتاج قطعی با تأخیر بسیار کم را مستقیماً در استراتژیهای استقرار مراکز داده سطح بالای خود ادغام کند. اسناد SEC 10-K انویدیا نشان میدهد که حدود ۱۴.۴ میلیارد دلار از سرمایه مجوز به عنوان سرقفلی ثبت شده که مستقیماً به نیروی کار متخصص و توسعه فناوریهای آتی مرتبط است و تنها ۲.۵ میلیارد دلار مستقیماً به طراحیهای پایه سختافزاری اختصاص یافته است. در همین حال، نهاد باقیمانده گروک با تغییر رویکردی تهاجمی به سمت خدمات هوش مصنوعی ابری، مدیریت مراکز داده و استقرار فناوریهای خود تحت عنوان جدید «انویدیا گروک ۳ LPX» حرکت کرده است. این مانور حقوقی و تجاری پرمخاطره، نحوه تصاحب استعدادهای مهندسی و دور زدن کانالهای نظارت ضد انحصار توسط شرکتهای تریلیون دلاری را بازتعریف میکند و همزمان، معماریهای سیلیکونی طراحیشده برای مراحل رمزگشایی مدلهای زبانی بزرگ (LLM) در مقیاس عظیم را مستحکم میسازد.
نوآوریهای کلیدی معماری و فناوری
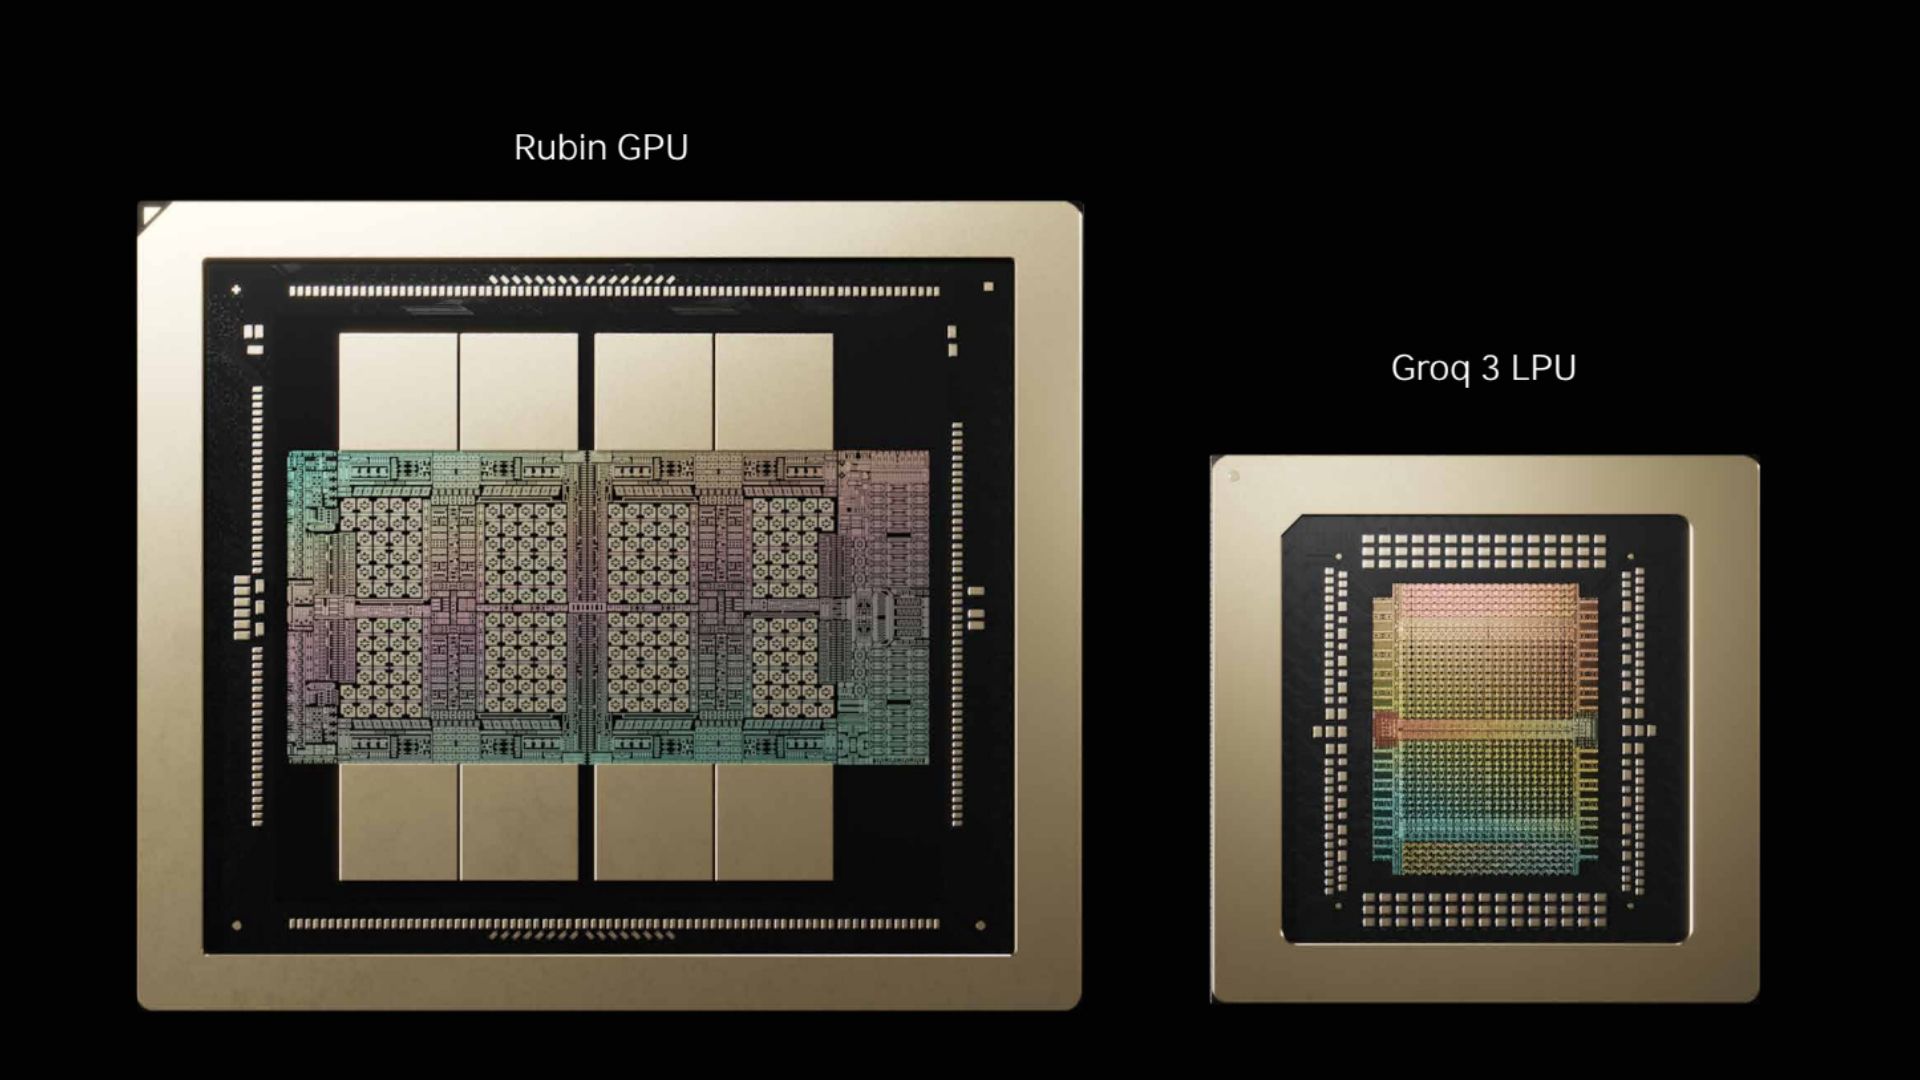
در سطح سیلیکون، ثمره این معامله در «گروک LP30» تجلی یافته است؛ یک موتور استنتاج انقلابی که بر پایه فناوری ۴ نانومتری (SF4X) سامسونگ ساخته شده است. برخلاف معماریهای سنتی GPU که به شدت به سلسلهمراتب پیچیده کش و زمانبندی پویا متکی هستند، معماری «تنسور استریمینگ» گروک از یک مدل اجرای قطعیِ مبتنی بر نرمافزار بهره میبرد. هر تراشه LP30 دارای ۵۰۰ مگابایت SRAM پرسرعت است که مستقیماً روی تراشه تعبیه شده و پهنای باند حافظه ترکیبی عظیم ۱۵۰ ترابایت بر ثانیه برای هر تراشه را فراهم میکند. این فلسفه طراحی، گلوگاه «فون نویمان» ذاتی در چرخههای فراخوانی حافظه HBM خارج از تراشه را حذف کرده و LPU را در کنار زیرساختهای آتی «ورا روبین NVL72» انویدیا به یک کمکپردازنده رمزگشای فوقالعاده کارآمد تبدیل میکند.
با مقیاسپذیری این سیلیکون در سطح سیستم، رک «انویدیا گروک ۳ LPX» تعداد ۲۵۶ عدد LPU مجزا را در یک گره محاسباتی متراکم ادغام میکند. این معماری جمعی، ۱۲۸ گیگابایت SRAM توزیعشده فوقسریع روی تراشه، پهنای باند داخلی خیرهکننده ۴۰ پتابایت بر ثانیه و عملکرد ترکیبی ۳۱۵ پتافلاپس FP8 را ارائه میدهد. معماری LPX با عملکرد به عنوان یک کمکپردازنده رمزگشای تخصصی، مراحل تولید توکنِ محدود به حافظه را از هستههای اصلی تنسور برداشته و زمان رسیدن به اولین توکن و توان عملیاتی تولید توکن را برای حجمهای کاری عظیم هوش مصنوعی مولد به شدت تسریع میکند. نسخههای آتی نقشه راه، مانند LP35 با پشتیبانی بومی NVFP4 و LP40 که برای نسلهای آینده سیستمهای فاینمن طراحی شده است، نشان میدهند که انویدیا قصد دارد این مدل اجرای قطعی را در سراسر پشته مراکز داده چند نسلی خود نهادینه کند.
مشخصات تجربی و ماتریس بنچمارک
| پارامتر معماری | رک Groq LP30 / LPX | گره استنتاج GPU پایه (H100/B200) | مزیت / بدهبستان |
|---|---|---|---|
| گره فرآیند | ۴ نانومتری سامسونگ (SF4X) | TSMC 4N / کلاس ۳ نانومتری | تراکم ترانزیستوری بالاتر در برابر اکوسیستم تولیدی بالغ |
| حافظه روی تراشه (SRAM) | ۵۰۰ مگابایت در هر تراشه / ۱۲۸ گیگابایت در هر رک | کش محدود L2 (حدود ۵۰-۱۰۰ مگابایت) | ظرفیت عظیم و قطعی Scratchpad |
| حافظه خارج از تراشه | متمرکز بر SRAM (بدون وابستگی به HBM) | HBM3e / HBM4 (تا ۸ ترابایت بر ثانیه در هر GPU) | حذف جریمههای تأخیر خارج از تراشه برای استنتاج |
| پهنای باند ترکیبی | ۱۵۰ ترابایت بر ثانیه (در هر تراشه) / ۴۰ پتابایت بر ثانیه (رک) | حدود ۸ ترابایت بر ثانیه در هر گره شتابدهنده | توان عملیاتی بیسابقه در تولید توکن |
| عملکرد محاسباتی | ۱.۲۳ پتافلاپس FP8 (تک LPU) | توان عملیاتی متغیر هسته تنسور FP8 | بهینهسازی صریح برای مراحل رمزگشایی قطعی |
حرارت، بهرهوری و ارگونومی در دنیای واقعی
ادغام ۲۵۶ عدد LPU در کنار آرایههای عظیم SRAM در فضای استاندارد یک رک سرور، چالشهای جدی چگالی حرارتی ایجاد میکند. برخلاف خوشههای GPU سنتی که در آنها اتلاف حرارت تحت سلطه پشتههای HBM پرقدرت و تراشههای محاسباتی عظیم یکپارچه است، معماری گروک LPX بارهای حرارتی را در تعداد زیادی از تراشههای کوچکتر، فرکانس بالا و مبتنی بر SRAM که روی گره ۴ نانومتری سامسونگ ساخته شدهاند، توزیع میکند. این نمایه حرارتی توزیعشده نیازمند ادغام خنککنندههای مایع سفارشی برای حفظ دمای بهینه اتصال است، به ویژه هنگام کار در مراکز داده متراکم ۲۰۰+ مگاواتی که گروک و شرکای ابری آن در حال گسترش آن هستند.
از نظر بهرهوری، حذف رابطهای حافظه خارج از تراشه پرمصرف (مانند HBM چند پشتهای) منجر به افزایش قابلتوجه بهرهوری در مرحله تولید توکن اتورگرسیو میشود. با نگه داشتن مجموعههای کاری فعال کاملاً در محدوده ۱۲۸ گیگابایتی SRAM در یک رک ۲۵۶-LPU، مصرف برق دینامیک به ازای هر توکن تولید شده در مقایسه با معماریهای سنتی که مکرراً وزنها را از DRAM خارجی فراخوانی میکنند، به شدت کاهش مییابد. بنچمارکهای استقرار در دنیای واقعی نشان میدهند که این خط لوله قطعی، تأخیرهای دم (Tail Latencies) را به حداقل میرساند و SLAهای عملیاتی قابل پیشبینی را برای ارائهدهندگان ابری هوش مصنوعی سازمانی مانند «نبیس» (Nebius) و شرکای ادغامکننده «دل» (Dell) که در حال مقیاسدهی خوشههای استنتاج تولیدی هستند، تضمین میکند.
حکم نهایی
معامله ۲۰ میلیارد دلاری انویدیا و گروک، یک شاهکار در تصاحب مهندسی شرکتی مدرن محسوب میشود که با موفقیت ضمن دور زدن موانع ادغام استاندارد، استعدادهای برتر LPU و مالکیت معنوی این صنعت را تصاحب کرد. از نظر معماری، پلتفرم حاصل یعنی Groq 3 LPX و سیلیکون LP30 زیربنای آن، جهشی بزرگ در بهرهوری تولید توکن اتورگرسیو محسوب میشوند و ثابت میکنند که مدلهای اجرای مبتنی بر SRAM و تعریفشده توسط نرمافزار، نقشی دائمی و حیاتی در استقرار هوش مصنوعی در مقیاس بسیار بزرگ (Hyperscale) دارند. با این حال، سایه تحقیقات فعال وزارت دادگستری و دعاوی حلنشده سهامداران در دلاور، نوسانات نظارتی پایداری را به افق تجاری بلندمدت این سختافزار تزریق میکند. برای خریداران سازمانی و معماران ابری، عملکرد سختافزاری بدون شک ممتاز است؛ اما برای بازار وسیعتر نیمههادیها، این معامله سابقهای بحثبرانگیز ایجاد میکند که برای همیشه نحوه تصاحب مالکیت معنوی و تیمهای مهندسی نخبگان را بازسازی خواهد کرد.