Resumen ejecutivo y posicionamiento en el mercado
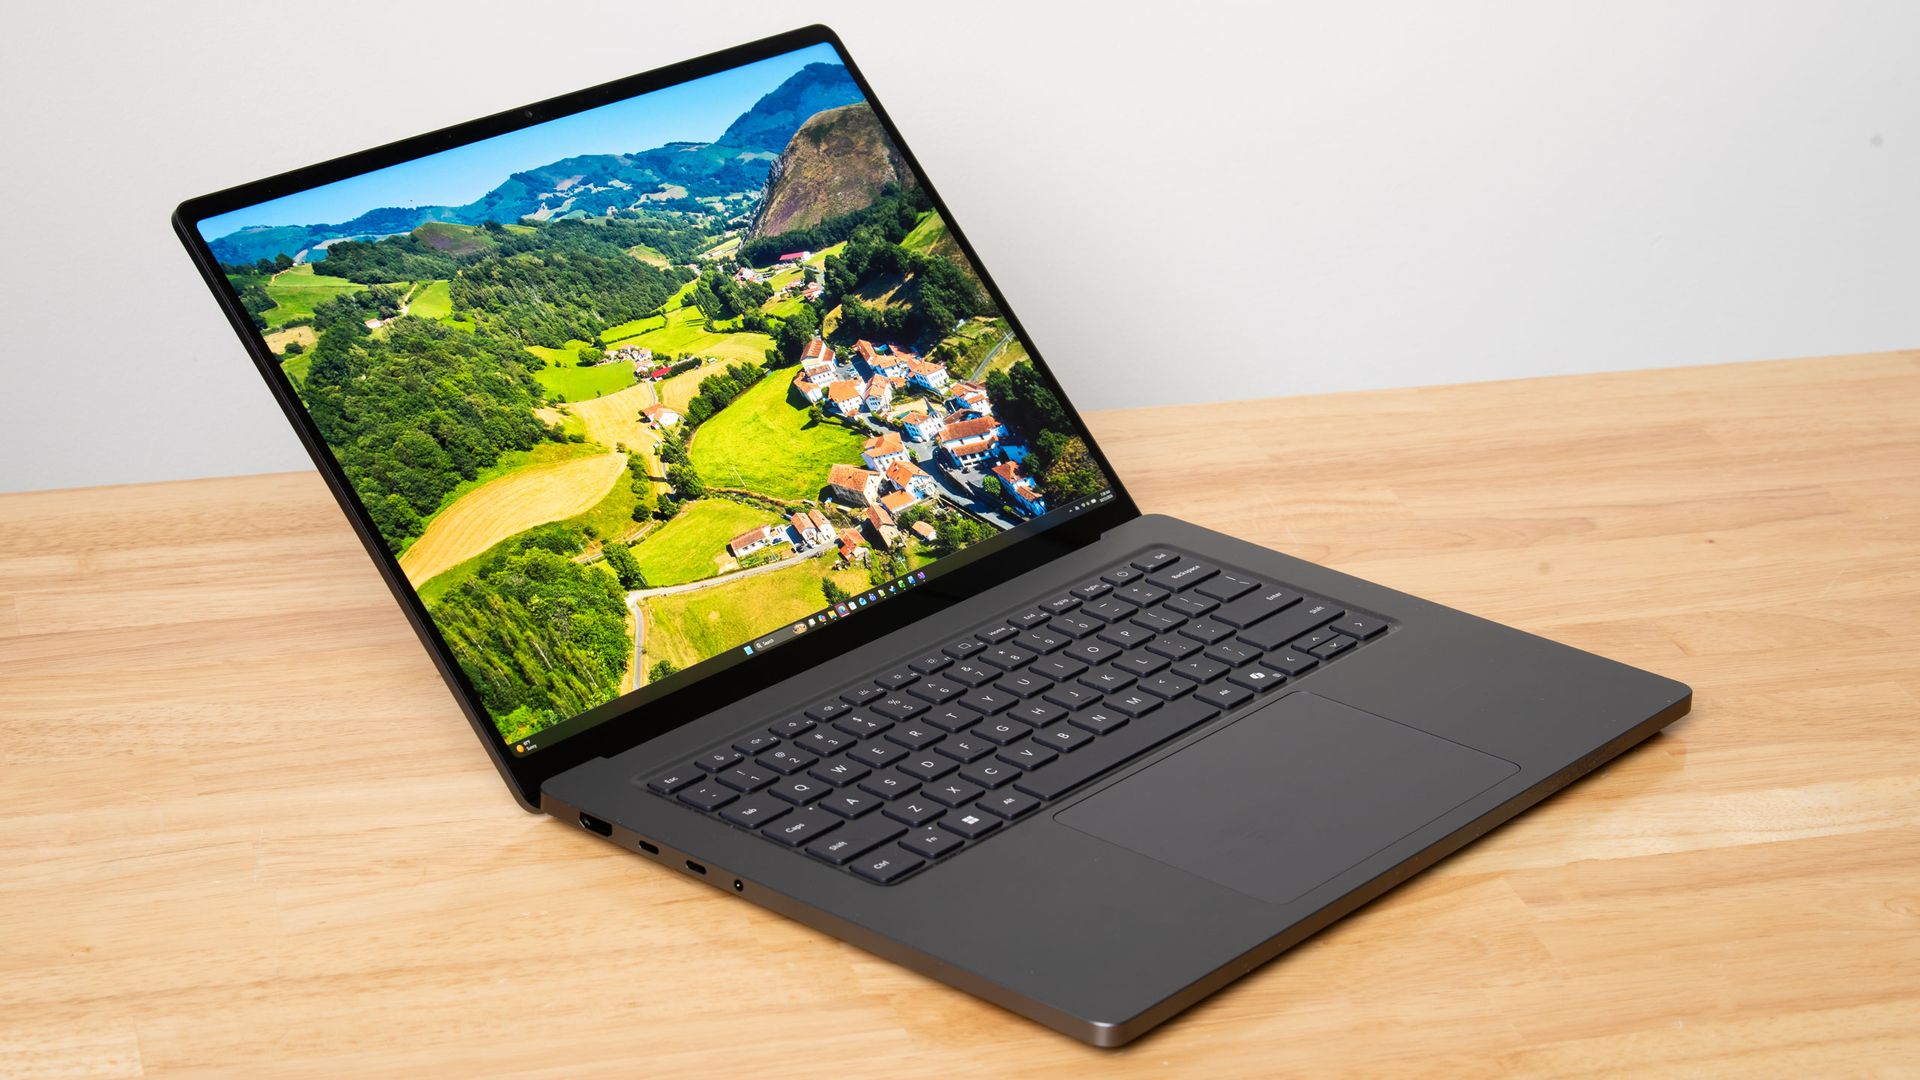
El paradigma informático está cambiando rápidamente de la ejecución de software estático a flujos de trabajo de agentes autónomos y dinámicos. La introducción por parte de Nvidia de la plataforma RTX Spark, anclada por el superchip GB10, representa una apuesta calculada para reinventar la arquitectura de los PC móviles. Evaluado dentro del Surface Laptop Ultra de gama alta de Microsoft —equipado con 128 GB de memoria RAM LPDDR5X-9400—, este conjunto de hardware está dirigido a usuarios profesionales, operadores empresariales y profesionales intensivos de la IA local. El objetivo estratégico de Nvidia es claro: integrar capacidades de inferencia y computación paralela de nivel de centro de datos en un chasis elegante y portátil.
Sin embargo, esta convergencia de hardware impulsada por la ambición deja al descubierto notables dolores de crecimiento generacionales. Si bien los límites de la ejecución de IA local se reescriben por completo gracias a la arquitectura masivamente paralela de Spark, las cargas de trabajo localizadas tradicionales y la madurez del ecosistema de software cuentan una historia más matizada. Posicionada directamente frente al silicio M5 Max de Apple y los sistemas Ryzen AI Halo de AMD, la plataforma RTX Spark se forja una identidad operativa distinta. Sacrifica el rendimiento bruto de la CPU y la procedencia en la ejecución de juegos a cambio de unas velocidades de finalización de tareas de agentes de extremo a extremo sin precedentes, estableciendo un nuevo punto de referencia para lo que el hardware neural local puede lograr en un formato móvil.
Innovaciones tecnológicas y arquitectónicas principales
A nivel de silicio, la plataforma RTX Spark se basa en un diseño heterogéneo que combina un complejo de CPU de 20 núcleos (con núcleos de arquitectura Arm derivados de MediaTek) con una monstruosa GPU de 6,144 núcleos CUDA y 48 multiprocesadores de streaming. Este diseño está optimizado específicamente para la ejecución localizada de transformadores, esquemas de decodificación especulativa como DFlash2 y canales de predicción de múltiples tokens (MTP). Al integrar 128 GB de memoria LPDDR5X-9400 ultrarrápida directamente en el subsistema de memoria unificada, Nvidia evita los cuellos de botella de ancho de banda PCIe tradicionales que históricamente paralizaban la ejecución de modelos de lenguaje grande (LLM) en hardware de cliente.
A pesar de estos triunfos arquitectónicos, el rendimiento bruto de la CPU revela el actual talón de Aquiles de la plataforma. En las evaluaciones de Geekbench de uno y varios núcleos, el complejo de CPU Arm de origen MediaTek se queda visiblemente por detrás del silicio M5 Max de Apple. El Spark no se siente lento durante la navegación rutinaria por el escritorio o las tareas de productividad básicas, pero las cargas de trabajo de compilación pesadas y los cálculos serializados vinculados a la CPU exponen un déficit de rendimiento en comparación con arquitecturas maduras. Sin embargo, cuando se le asignan modelos complejos de inteligencia localizada como el denso Qwen 3.8-27B o el modelo de mezcla de expertos Qwen 3.6 35B A3B, el diseño de núcleos CUDA libera un rendimiento paralelo masivo, lo que hace que las disparidades de la CPU sean insignificantes durante las tareas de los agentes.
Especificaciones empíricas y matriz de pruebas comparativas
| Característica / Métrica | Nvidia RTX Spark (Surface Laptop Ultra) | Apple M5 Max (MacBook Pro de 14") | AMD Ryzen AI Halo (Strix Halo) | Ventaja arquitectónica / Notas |
|---|---|---|---|---|
| Recuento de núcleos de CPU | 20 núcleos (basado en Arm) | 18 núcleos (Apple Silicon) | Zen 5 + motor XDNA 2 | Apple lidera en IPC de CPU pura de un hilo/multihilo. |
| Unidades de cómputo de GPU | 6.144 núcleos CUDA (48 SM) | GPU de 40 núcleos / Metal | RDNA 3.5 integrada | Nvidia domina en la aceleración de vectores paralelos puros. |
| Memoria del sistema | 128 GB LPDDR5X-9400 | 128 GB LPDDR5X | Hasta 128 GB unificados | El gran ancho de banda es esencial para MoE y LLM densos. |
| AgentPerf-local (27B) | Más rápido (aprox. 25% más rápido que Mac) | Competitivo, limitado por la memoria | ~40 minutos (significativamente más lento) | La arquitectura Spark minimiza la latencia de los agentes de extremo a extremo. |
| AgentPerf-local (35B) | Tiempo de finalización: 8 minutos | Tiempo de finalización: 10 minutos | Tiempo de finalización: 13 minutos | Demuestra un rendimiento superior en la generación de tokens. |
Térmica, eficiencia y ergonomía en el mundo real
El análisis del consumo térmico y eléctrico del Surface Laptop Ultra revela la agresiva optimización necesaria para mantener la plataforma RTX Spark. Alimentado a través de un adaptador de corriente de 140 W (que coincide con el nivel utilizado por los MacBooks de 16 pulgadas más grandes), este chasis de 15 pulgadas aprovecha al máximo el margen de disipación térmica. Si bien la elaboración de perfiles completos de la duración de la batería sigue estando restringida por las limitaciones actuales del embargo de lanzamiento, el diseño térmico prioriza claramente la entrega de computación sostenida por encima de la eficiencia pasiva y sin ventilador.
Al ejecutar cargas de trabajo de agentes exigentes a través de la suite AgentPerf-local de Artificial Analysis, el hardware mantiene el equilibrio térmico de manera efectiva, evitando una limitación térmica agresiva. El sistema completó la inferencia del denso modelo Qwen 3.8-27B un 25% más rápido que el MacBook Pro M5 Max de 14 pulgadas, una victoria atribuible en parte al generoso consumo de energía y al diseño de refrigeración activa del chasis Surface. Por el contrario, el formato compacto para ordenadores de sobremesa Ryzen AI Halo de AMD requirió aproximadamente el doble de tiempo de ejecución para completar cargas de trabajo de agentes idénticas, lo que subraya que la eficiencia arquitectónica pura y la entrega de energía sostenida no son negociables para la ejecución de IA profesional.
El veredicto definitivo
La plataforma RTX Spark de Nvidia dentro del Microsoft Surface Laptop Ultra es un triunfo de la ingeniería de hardware especializada para la era de la IA. Obtiene de manera decisiva la corona en la finalización de tareas de agentes locales, superando al M5 Max de Apple y al Strix Halo de AMD en pruebas de referencia de inferencia de LLM complejas y de múltiples turnos como AgentPerf-local. Para desarrolladores, científicos de datos y usuarios avanzados cuyos flujos de trabajo diarios dependen de la ejecución rápida de modelos locales y de la productividad de los agentes autónomos, la arquitectura Spark justifica su posicionamiento de hardware prémium.
Sin embargo, esta no es una panacea universal para los consumidores. Los núcleos de CPU de la plataforma derivados de MediaTek se quedan atrás de las arquitecturas de la competencia en cuanto a potencia de procesamiento bruta, y el ecosistema de software inicial que rodea a la plataforma requiere un refinamiento continuo. Además, a pesar de su fuerte marca RTX y su enorme recuento de núcleos CUDA, el rendimiento en los juegos tradicionales sigue siendo un punto fuerte secundario y poco desarrollado, lo que significa que los futuros compradores deben evaluar este sistema desde una perspectiva de productividad empresarial en lugar de una perspectiva de entretenimiento de consumo. En última instancia, el RTX Spark reinventa con éxito la estación de trabajo para PC profesional, siempre que su definición de trabajo se centre enteramente en la inteligencia artificial.