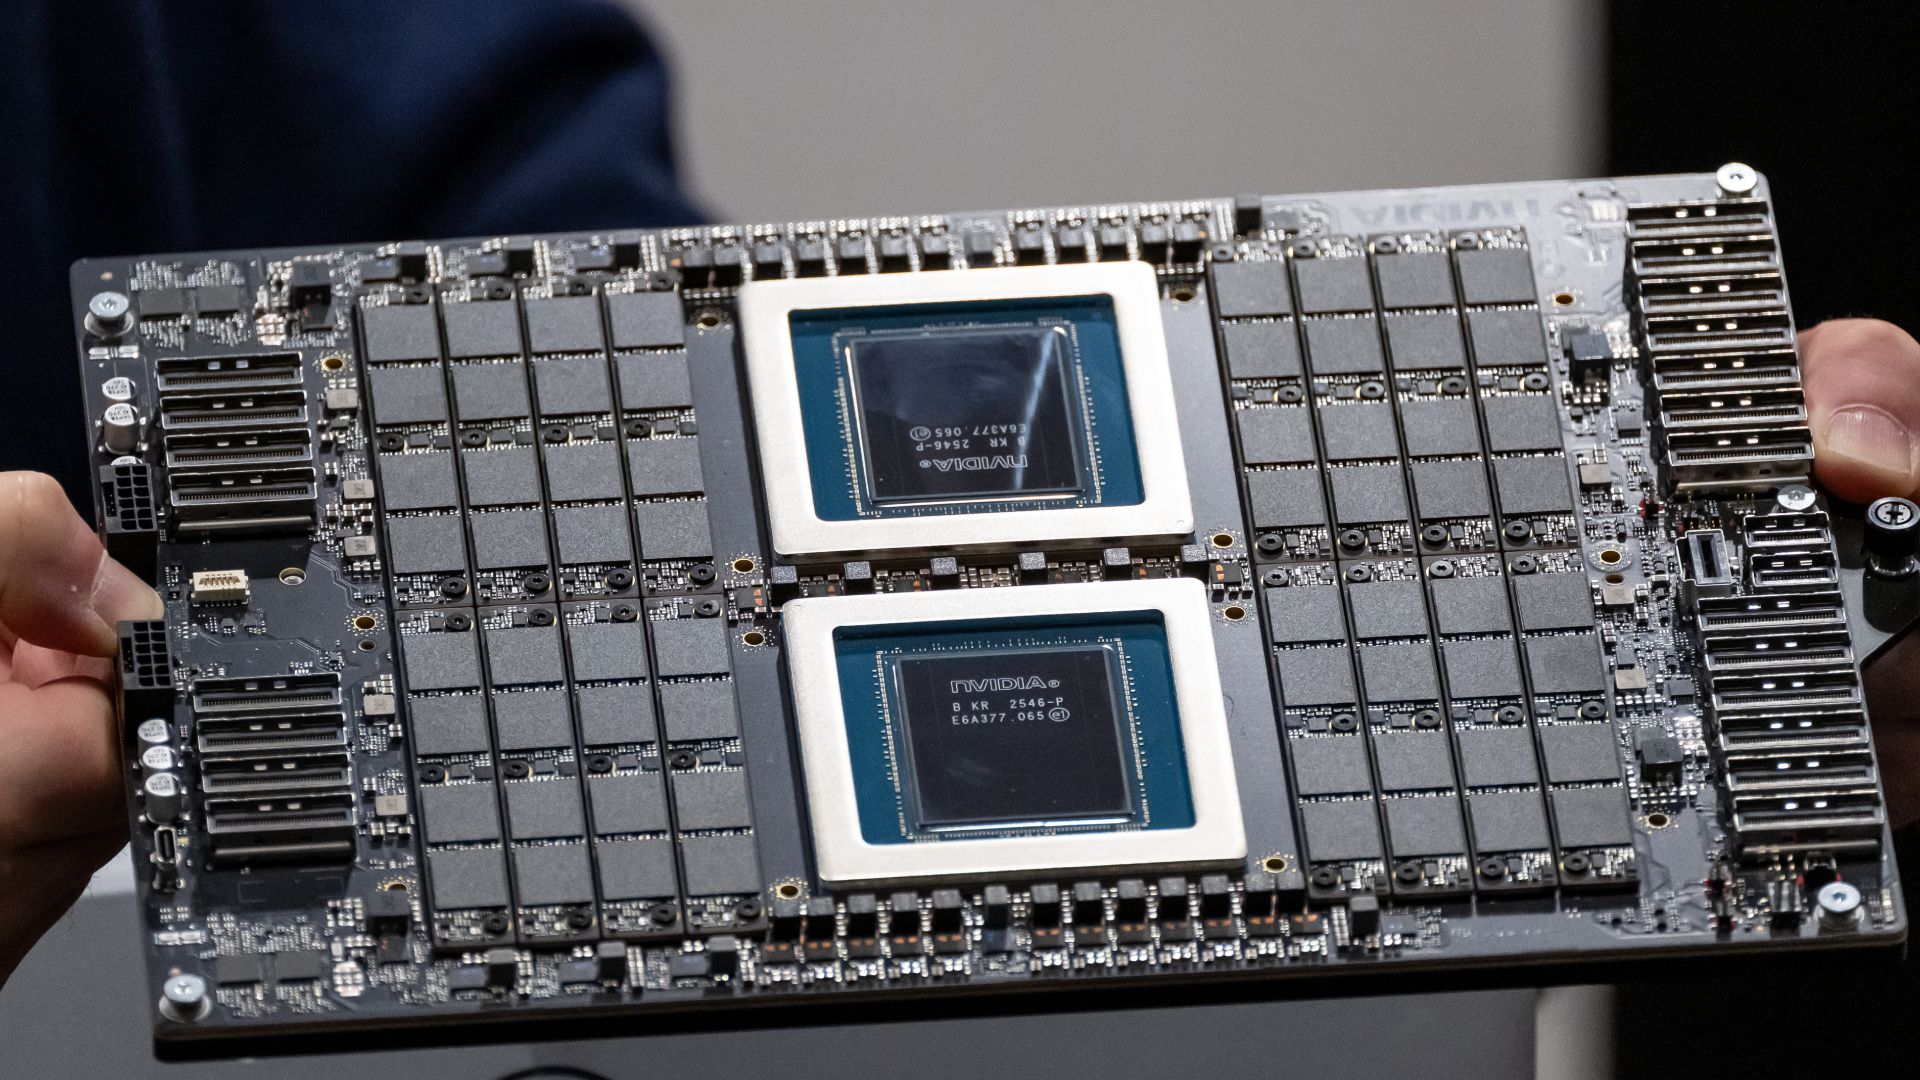
Resumen Ejecutivo y Posicionamiento en el Mercado
El anuncio de disponibilidad general de las CPU Vera de Nvidia dentro de los Superclusters de Oracle Cloud Infrastructure (OCI) marca un momento decisivo en la arquitectura de servidores empresariales. Si bien las neoclouds como Nscale, CoreWeave y Nebius se han inclinado fuertemente hacia implementaciones céntricas en GPU, la integración estratégica de Oracle de instancias Vera independientes señala un cambio profundo. Este es el primer viaje de Nvidia para llevar una CPU independiente y no acelerada directamente al centro de la corriente principal de los centros de datos a hiperescala, preparando el escenario para una colisión frontal con la arraigada hegemonía de x86 dominada por Intel y AMD.
Históricamente, la estrategia de computación en centros de datos de Nvidia ha acoplado estrechamente sus CPU propietarias con sus GPU líderes en la industria. Sin embargo, la disponibilidad independiente de Vera en un hiperescalador de primer nivel como Oracle rompe este molde. Posiciona la arquitectura no meramente como un procesador host auxiliar para matrices Rubin o Blackwell, sino como un nodo de computación de propósito general viable por derecho propio. Si bien los próximos contendientes como el EPYC Venice de 256 núcleos de AMD apuntan a la densidad de hilos en socket simple sin procesar, la apuesta calculada de Nvidia con Vera prioriza la topología y la eficiencia del subsistema de memoria. Esta diferenciación estratégica tiene como objetivo capturar el mercado en rápida expansión para cargas de trabajo de alta concurrencia e intensivas en datos.
Innovaciones Arquitectónicas y Tecnológicas Clave
A nivel de silicio, la arquitectura Vera se desvía drásticamente de las filosofías de diseño x86 tradicionales. En lugar de depender de controladores de memoria centralizados y cachés masivos a nivel de sistema característicos de las ofertas contemporáneas de Intel y AMD, Vera emplea un diseño de dado monolítico combinado con una sofisticada caché de malla distribuida. Este diseño propietario sustenta la segunda generación del Tejido de Coherencia Escalable (SCF) de Nvidia, alterando fundamentalmente cómo los datos atraviesan el sustrato de silicio.
Esta topología rinde dividendos masivos en vectores de ejecución limitados por la memoria. Al utilizar módulos de memoria LPDDR5X-9600 de alta velocidad, Vera logra un perfil de ancho de banda de memoria teórico y empíricamente validado que altera profundamente las líneas base empresariales estándar. Cuando se aprovecha adecuadamente utilizando técnicas avanzadas de vinculación de procesos —como la política "spread" de OpenMP que fuerza a los procesos a estar lo más lejos posible físicamente a través de la malla—, la arquitectura elude los cuellos de botella impuestos típicamente por las interconexiones en anillo o de malla tradicionales que se encuentran en entornos empresariales de doble socket.
Especificaciones Empíricas y Matriz de Rendimiento
| Métrica / Característica | Nvidia Vera (Independiente) | Intel Xeon 6980P (Doble Socket) | AMD EPYC Venice (Proyectado) |
|---|---|---|---|
| Tipo de Memoria | LPDDR5X-9600 | MRDIMM (8,800 MT/s) | DDR5 de 16 canales |
| Ancho de Banda Stream Triad | >1.2 TB/s (Pico medido) | ~0.55 TB/s | Alta densidad escalada |
| Tejido de Interconexión | Tejido de Coherencia Escalable de 2.ª Gen. | Ultra Path Interconnect (UPI) | Infinity Fabric |
| Densidad de Socket | Dado monolítico / Malla | Arquitectura de doble socket | Hasta 512 hilos / socket |
El análisis de puntos de referencia independientes corrobora las agresivas afirmaciones de rendimiento de Nvidia. En el punto de referencia Stream estándar de la industria, la operación Triad de Vera duplica con creces el ancho de banda de memoria agregado disponible en un sistema dual Intel Xeon 6980P, incluso cuando este último está equipado con MRDIMM de vanguardia que funcionan a 8,800 MT/s. Esta asombrosa ventaja de ancho de banda se traduce directamente en tareas del mundo real; las evaluaciones empíricas de consultas de bases de datos SQLite demuestran que el SCF de Vera acelera de manera eficiente las rutas de ejecución que están inherentemente limitadas por el movimiento de datos en todo el sistema.
Térmica, Eficiencia y Ergonomía del Mundo Real
Ejecutar bucles agénticos complejos —como los que potencian marcos de IA modernos como CrewAI y LangGraph construidos sobre bases de Python— requiere un rendimiento sostenido a través de la memoria y las unidades de ejecución de núcleos. La naturaleza interpretada de Python tradicionalmente impone un fuerte impuesto sobre la latencia y el ancho de banda de la memoria, lo que hace que la integración LPDDR5X de Vera sea una combinación física ideal. En las evaluaciones de PyBench, Vera supera rutinariamente y por un amplio margen a su categoría de peso, superando a silicio de la competencia que presume de mejores especificaciones sobre el papel debido estrictamente a su implacable alimentación de memoria.
Sin embargo, llevar una arquitectura novedosa a entornos empresariales de varios gigavatios exige precaución operativa. La estrategia de implementación multifacética de Oracle —que ofrece instancias Vera independientes junto con configuraciones híbridas como el HGX NVL8 emparejado con dos hosts Intel Xeon 6 de 64 núcleos y 4 TB de DDR5— ilustra una transición medida. La gestión térmica de matrices LPDDR5X densas de alto ancho de banda y dados monolíticos que operan bajo cargas de trabajo agénticas sostenidas requiere topologías robustas de refrigeración líquida o aire avanzado, para cuya entrega los Superclusters de OCI están específicamente diseñados.
El Veredicto Definitivo
La CPU Vera de Nvidia es mucho más que un simple acompañamiento para el ecosistema de GPU Rubin. Nuestras pruebas empíricas confirman que su caché de malla distribuida y su vertiginoso subsistema de memoria LPDDR5X-9600 ofrecen una victoria decisiva en cargas de trabajo muy concurrentes y limitadas por la memoria, superando cómodamente a las configuraciones x86 heredadas de doble socket en las métricas de Stream y SQLite. Si bien AMD e Intel conservan la corona en cuanto a densidad de hilos pura por socket, Vera demuestra que la topología y el ancho de banda pueden superar los recuentos de núcleos brutos en la era emergente de la IA agéntica. Para los hiperescaladores y las empresas que lidian con graves cuellos de botella en el movimiento de datos, Vera surge como una alternativa formidable y altamente disruptiva al silicio de servidor tradicional.