Resumen Ejecutivo y Posicionamiento en el Mercado
Informes financieros recientes indican que SpaceX está diseñando activamente un enorme paquete de deuda de 40.000 millones de dólares programado para 2027, concebido principalmente para adquirir procesadores de inteligencia artificial Nvidia de próxima generación. Si bien las estructuras corporativas canalizan formalmente esta iniciativa a través del ecosistema más amplio de Elon Musk, el beneficio operativo se dirige a los clústeres de computación a hiperescala de xAI. El vehículo financiero propuesto combina supuestamente 10.000 millones de dólares en préstamos bancarios directos con 30.000 millones de dólares en deuda de grado de inversión, y se rumorea que pesos pesados financieros como Apollo Global Management y Pimco lideran la estructuración. Esta inyección de capital sin precedentes subraya un cambio fundamental en la adquisición de infraestructura a hiperescala, moviéndose más allá del capital de riesgo tradicional y los flujos de caja corporativos hacia instrumentos de deuda a escala soberana.
Desde el punto de vista del posicionamiento en el mercado, este gasto rompe los precedentes históricos de los ciclos de adquisición de hardware para entidades individuales. Basándose en los despliegues anteriores de xAI, como las iteraciones del clúster Colossus que aprovechan cientos de miles de aceleradores con arquitectura Blackwell, el cronograma de implementación de 2027 se mapea directamente a la próxima generación Vera Rubin de Nvidia. Al asegurar miles de millones en financiación de hardware dedicada con años de antelación, xAI está intentando adelantarse a la escasez global de silicio, asegurar asignaciones de fundiciones de primer nivel y mantener una trayectoria agresiva en la carrera armamentista de los modelos fundamentales de IA generativa. Esta estrategia trata el silicio avanzado no solo como un gasto de capital, sino como un activo estratégico primario comparable a la infraestructura industrial pesada.
Innovaciones Arquitectónicas y Tecnológicas Principales
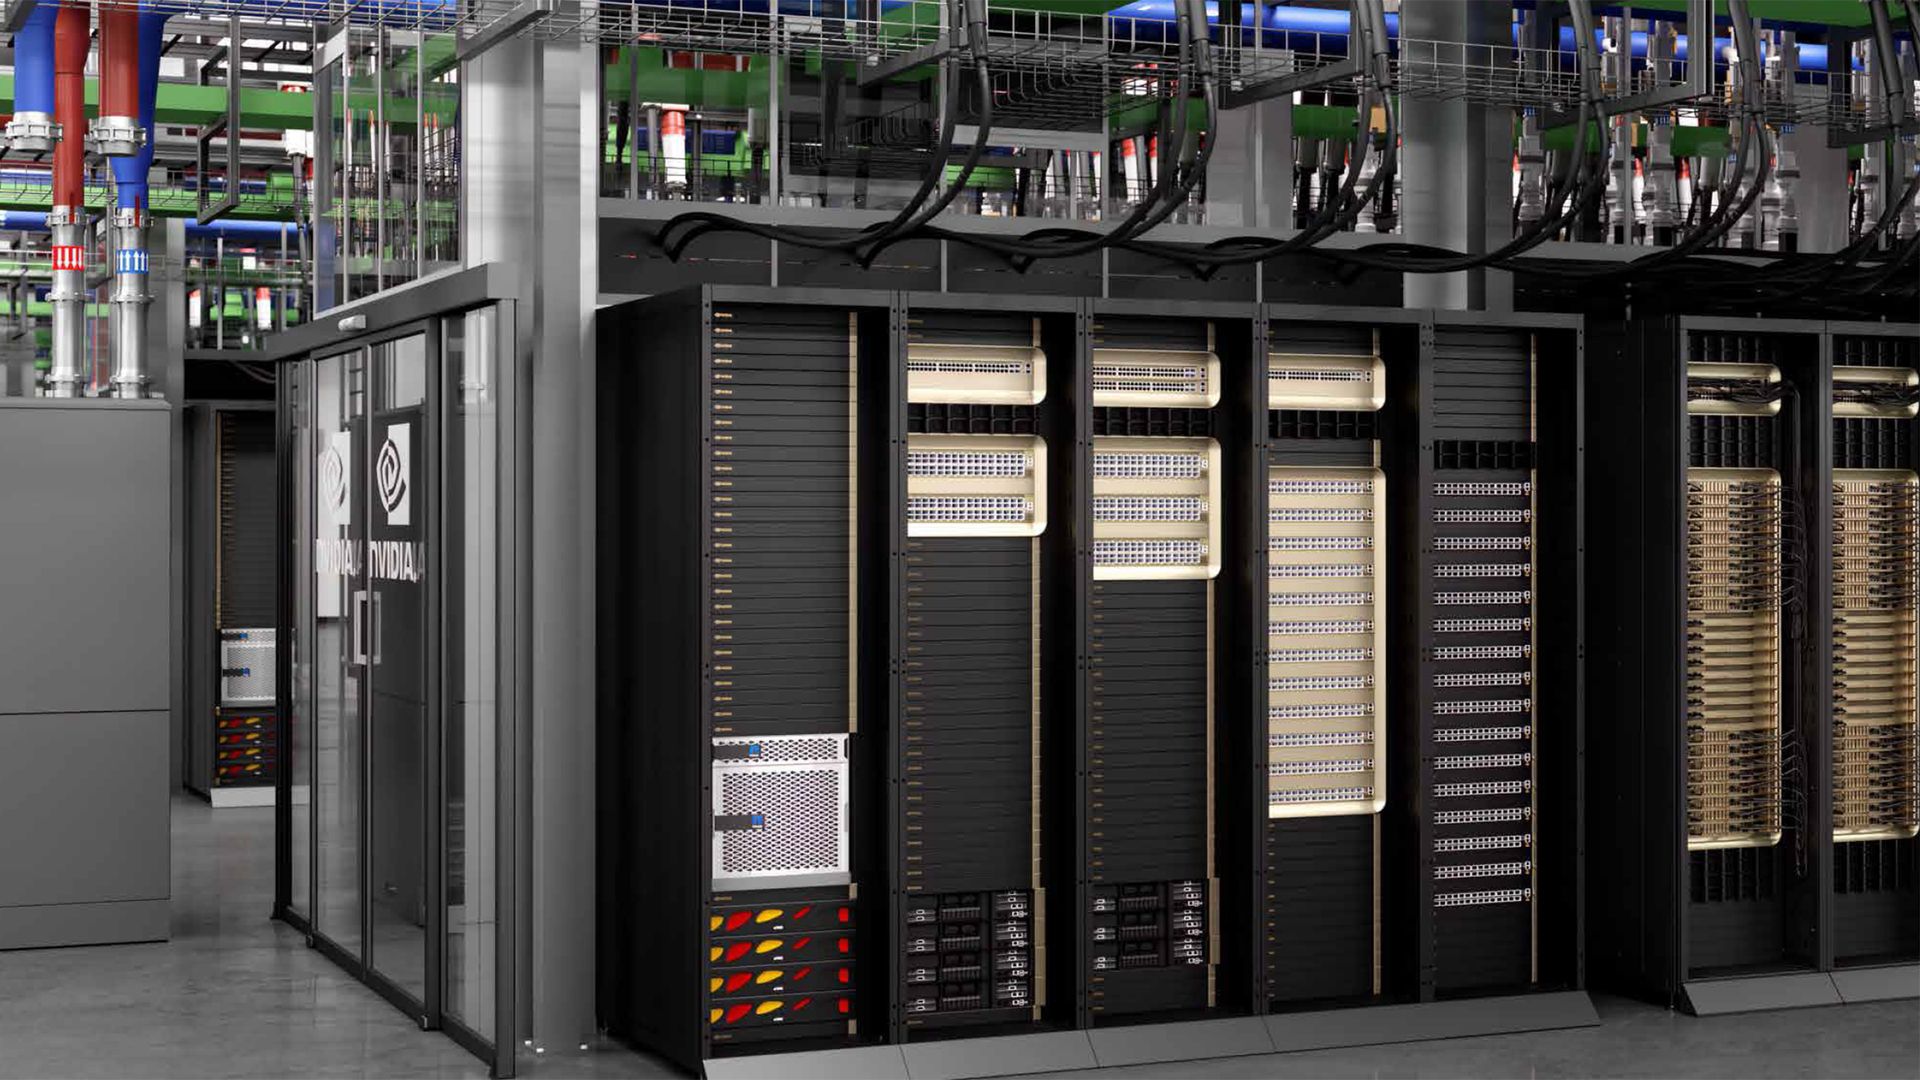
El ancla tecnológica de este gasto proyectado de 40.000 millones de dólares es la próxima arquitectura Vera Rubin de Nvidia, que se espera específicamente que se despliegue en configuraciones a escala de rack similares al Rubin NVL72. Más allá de los paradigmas arquitectónicos de Hopper y Blackwell, la generación Rubin introduce revisiones radicales en las proporciones de computación a memoria, la integración de interconexiones ópticas y los tejidos de conmutación NVLink propietarios. Con unidades de rack individuales que alcanzan valoraciones astronómicas (estimadas en alrededor de 8,8 millones de dólares por conjunto NVL72), el hardware representa la vanguardia absoluta de la computación heterogénea densa. Cada rack integra procesadores diseñados a medida, memoria avanzada de gran ancho de banda (HBM4) y silicio codiseñado optimizado para cargas de trabajo masivas de inferencia y entrenamiento basadas en transformadores.
A una escala macro, asignar 40.000 millones de dólares al ecosistema Rubin NVL72 se traduce en aproximadamente 5.000 sistemas de rack totalmente integrados que albergan cerca de 360.000 aceleradores de IA Nvidia Rubin individuales. Esta densidad altera drásticamente los requisitos de topología del centro de datos. A diferencia de los despliegues de servidores tradicionales, donde los nodos se ensamblan de forma incremental a partir de placas base y tarjetas de interfaz dispares, el enfoque de escala de rack de Rubin trata todo el chasis de 72 GPU como un único motor informático monolítico. Esto minimiza los cuellos de botella de latencia, maximiza el ancho de banda dentro del rack a través de matrices de transceptores ópticos de múltiples terabits y agiliza la compleja orquestación necesaria para entrenar modelos fundamentales de clase frontera sin sufrir de inanición inducida por la red.
Especificaciones Empíricas y Matriz de Referencia
| Métrica de Hardware | Nvidia Blackwell GB200 (Base) | Nvidia Vera Rubin NVL72 (Proyectado) | Delta Arquitectónico |
|---|---|---|---|
| Nodo de Proceso | TSMC 4NP Personalizado | Clase Avanzada N3 / N2 | Mayor densidad de transistores y menor fuga |
| Estándar de Memoria | HBM3e (hasta 192GB/paquete) | HBM4 (Mayor capacidad/ancho de bus) | Aumento exponencial del ancho de banda de memoria |
| Ancho de Banda de Interconexión | 1.8 TB/s bidireccional por GPU (NVLink) | Tejido de Conmutación NVLink de Próxima Gen | Menor latencia, mayor eficiencia de escalado |
| Costo Unitario Estimado | ~$3M – $4M por equivalente a rack | ~$8.8M por rack NVL72 | Refleja la escala de integración y las primas de HBM4 |
| Despliegue Objetivo | 2024–2025 (Iteraciones Colossus) | 2027 (Ventana objetivo de xAI) | Capacidad de entrenamiento de frontera de próxima generación |
Térmica, Eficiencia y Ergonomía del Mundo Real
Desplegar aproximadamente 360.000 aceleradores Rubin en 5.000 unidades de rack introduce desafíos termodinámicos y de ingeniería de instalaciones sin precedentes. Con densidades de potencia de rack individuales que superan con creces los 100 kilovatios (y potencialmente acercándose al umbral de 150 kW dependiendo del ajuste del reloj y la intensidad de la carga de trabajo), la refrigeración por aire es totalmente obsoleta para esta clase de hardware. Las instalaciones que alberguen el despliegue de xAI dependerán completamente de bucles de refrigeración avanzados de líquido a chip, colectores de distribución de refrigerante precisos (CDM) e intercambiadores de calor de bucle secundario de alta capacidad. La gestión térmica debe mantener temperaturas de unión estrictas para evitar el estrangulamiento térmico mientras se mantienen ejecuciones de entrenamiento ininterrumpidas de varios meses.
La ergonomía de la entrega de energía es igualmente formidable. Operar 5.000 racks densos exige infraestructura de subestaciones a escala de megavatios, sistemas robustos de almacenamiento de energía en baterías (BESS) para la estabilización de la red y fuentes de alimentación ininterrumpida (UPS) redundantes para mitigar microinterrupciones que de otro modo podrían corromper los estados de punto de control activos durante las ejecuciones de entrenamiento masivo de modelos. Las ganancias de eficiencia entregadas por los nodos de litografía avanzados de la arquitectura Rubin son cruciales aquí; sin mejoras dramáticas en el rendimiento por vatio, el consumo eléctrico puro de escalar a 360.000 unidades excedería los límites prácticos de interconexión de red de los pasillos de centros de datos estándar, obligando a los hiperescaladores a ubicarse junto a fuentes de generación de energía dedicadas.
El Veredicto Definitivo
La búsqueda calculada de SpaceX y xAI de un paquete de deuda de 40.000 millones de dólares para hardware Nvidia Rubin es una clase magistral de alto riesgo e intensiva en capital sobre el dominio de la infraestructura. Financieramente, aprovechar la deuda de grado de inversión a través de instituciones como Apollo y Pimco permite a la empresa asegurar computación generacional sin diluir el capital prematuramente. Tecnológicamente, el despliegue de aproximadamente 5.000 sistemas Vera Rubin NVL72 posiciona a xAI en la frontera absoluta de la capacidad global de inteligencia artificial, proporcionando los FLOPS brutos y el ancho de banda de memoria necesarios para superar a los competidores limitados por modelos convencionales de gasto de capital.
Recomendación Final: Tanto para analistas institucionales como para ingenieros de hardware, este movimiento señala que la carrera de la infraestructura de IA ha entrado en una fase a escala industrial donde el acceso a los mercados de deuda y el silicio avanzado a escala de rack dictan el liderazgo del mercado. Si bien la exposición financiera es asombrosa, los dividendos tecnológicos de asegurar 360.000 aceleradores Rubin aseguran que el foso de computación de xAI permanecerá virtualmente impenetrable hasta finales de la década de 2020.