Resumen ejecutivo y posicionamiento en el mercado
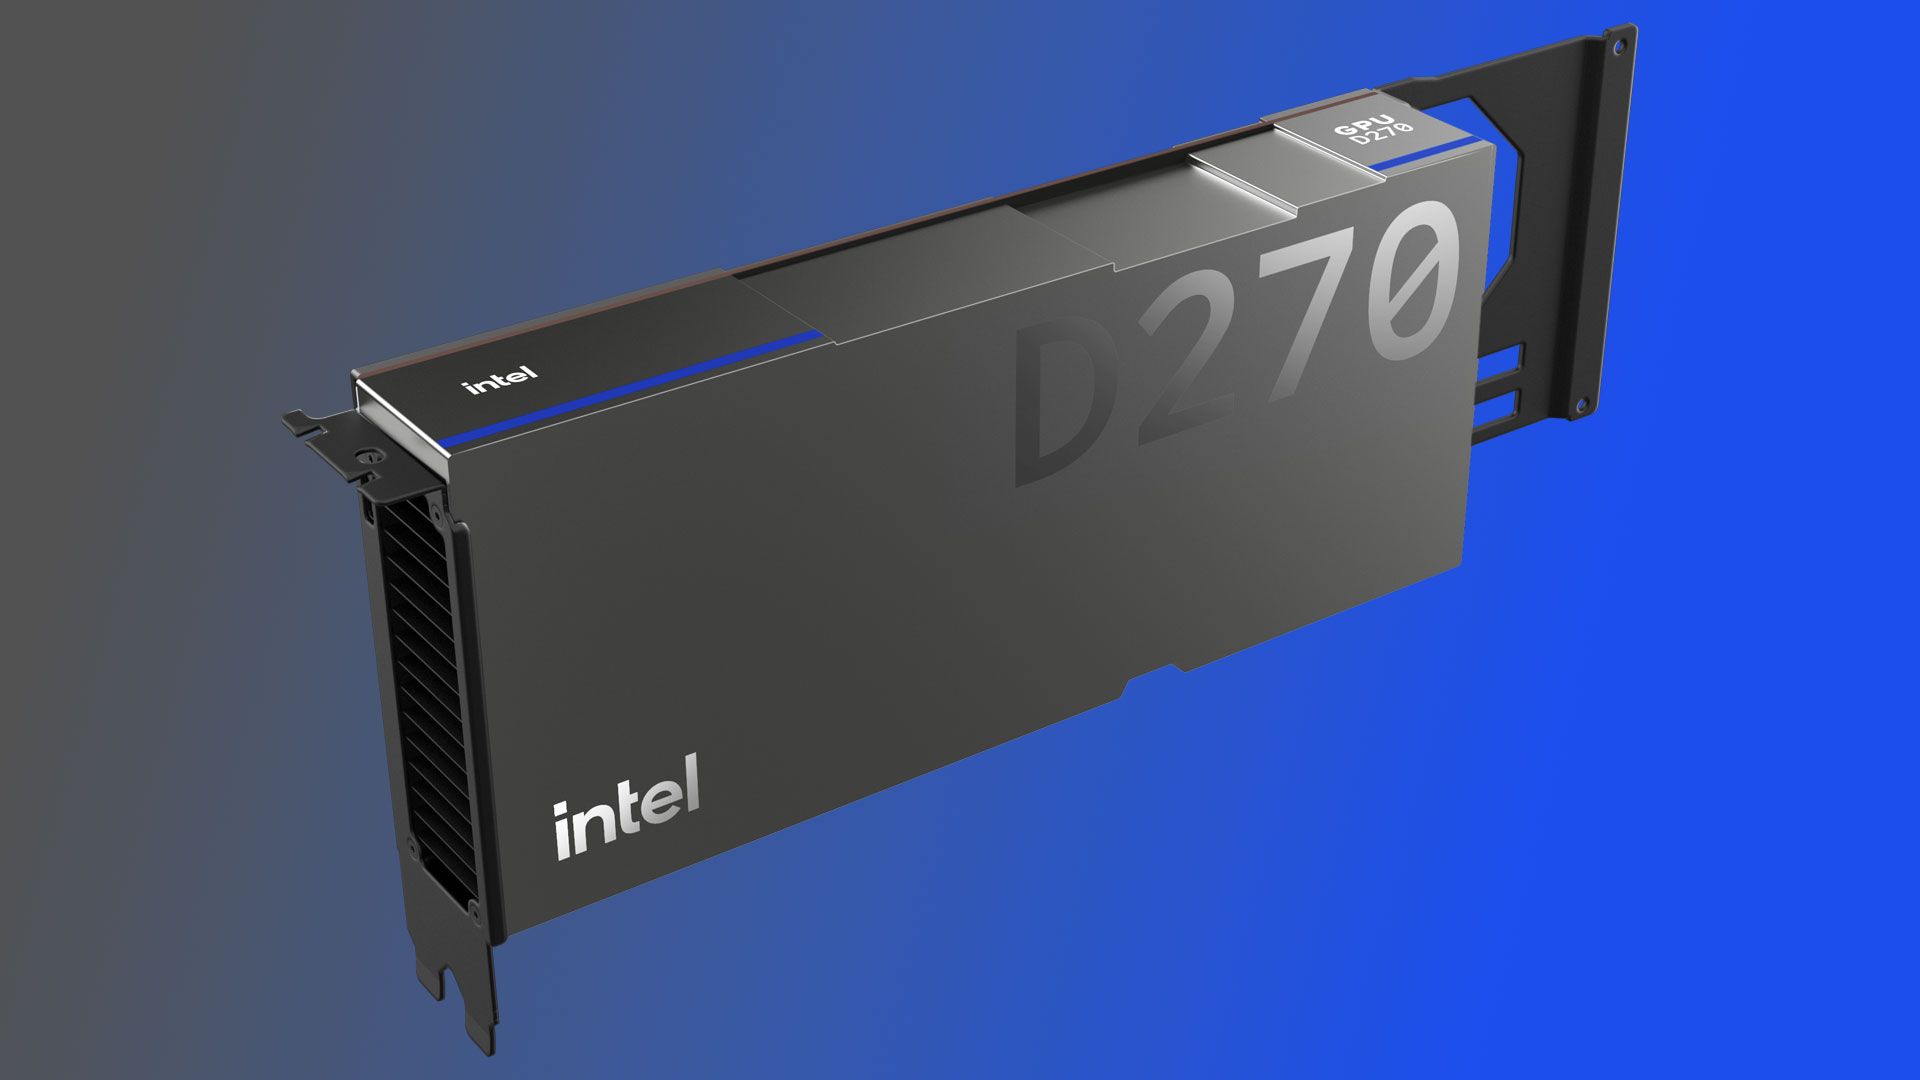
La presentación formal de Intel de la GPU serie D, conocida anteriormente por el nombre en clave "Crescent Island", representa un giro estratégico fundamental para las aspiraciones de la compañía en los centros de datos. Tras el rendimiento turbulento de la GPU Data Center Max (Ponte Vecchio) y la posterior disolución de sus hojas de ruta de aceleradores de gama alta más amplios, la GPU serie D marca un alejamiento de la competencia directa con los buques insignia Nvidia H100/Rubin de gama ultra alta. En cambio, Intel está posicionando este silicio como una potencia refrigerada por aire optimizada para la inferencia, dirigida al mercado masivo y desatendido de servidores empresariales a escala de rack que carecen de la infraestructura para densidades térmicas de refrigeración líquida de varios kilovatios por GPU.
La serie D es, en efecto, una admisión de que el camino hacia la relevancia en el mercado reside en la accesibilidad y el pragmatismo térmico, más que en el rendimiento absoluto de un único dado. Al priorizar un TDP de 350 W y factores de forma PCIe tradicionales, Intel está cortejando a la vasta población de entornos de infraestructura de IA heredados y de generación actual. Esta es una estrategia de "pan de cada día", que apunta a proporcionar una solución coherente y escalable para la inferencia multiusuario, la robótica y las tareas de IA orientadas al borde, donde la potencia por vatio y la simplicidad operativa tienen prioridad sobre el rendimiento máximo de entrenamiento.
Innovaciones arquitectónicas y tecnológicas fundamentales
En el corazón de la serie D se encuentra la arquitectura Xe3P, una derivación especializada de la base gráfica de Intel a la que se le han eliminado las canalizaciones tradicionales de rasterización y geometría. Esta no es una GPU en el sentido convencional, sino más bien un motor informático masivamente paralelo diseñado específicamente para la naturaleza intensiva en datos de la inferencia. El enfoque aquí está en el rendimiento de gran ancho de banda, evidenciado por el ancho de banda de memoria de 1,5 TB/s, que es fundamental para prevenir los cuellos de botella inherentes a la carga de modelos de grandes parámetros en búferes locales durante sesiones de inferencia simultáneas.
El compromiso de Intel con la "base de software común Xe" es el eje del éxito de este hardware. Históricamente, el talón de Aquiles de los esfuerzos de aceleradores discretos de Intel ha sido la desconexión entre la capacidad del silicio y la madurez del software. Al anclar la serie D a un ecosistema de software establecido que impregna sus ofertas integradas y discretas para dispositivos móviles y de escritorio, Intel intenta reducir la barrera de entrada para los desarrolladores. El objetivo es proporcionar una transición fluida para que los modelos optimizados para plataformas móviles basadas en Xe se implementen a escala en bastidores de la serie D, creando efectivamente una ruta de implementación de IA unificada desde el borde hasta el centro de datos.
Especificaciones empíricas y matriz de puntos de referencia
| Especificación | Intel GPU serie D | Nvidia Rubin (Est. por GPU) | Segmento de mercado |
|---|---|---|---|
| Arquitectura | Xe3P | Vera Rubin | Inferencia/Entrenamiento |
| Rendimiento máximo FP8 | 1.3 PFLOPS | 17.5 PFLOPS | Escalado |
| Ancho de banda de memoria | 1.5 TB/s | N/D (HBM4) | Rendimiento |
| TDP | 350W | 1000W+ | Envolvente térmica |
| Refrigeración | Aire | Líquida | Infraestructura |
Ergonomía térmica, eficiencia y del mundo real
Al limitar la GPU serie D a 350 W, Intel ha evitado efectivamente el obstáculo más importante para muchos clientes empresariales: las adaptaciones de refrigeración líquida. En el centro de datos moderno, los gastos generales de instalación de una infraestructura de refrigeración avanzada para un pequeño grupo de servidores de IA suelen ser prohibitivos. La serie D proporciona una capacidad de "conexión directa" para entornos de rack refrigerados por aire existentes, lo que permite a las empresas escalar su capacidad de inferencia hasta ocho GPU por nodo sin provocar una revisión masiva de sus sistemas de suministro de energía o refrigeración.
Además, la integración de hasta 480 GB de memoria LPDDR5X aborda la demanda de soporte de modelos de grandes parámetros en un espacio compacto. Si bien LPDDR5X sacrifica algo de velocidad absoluta en comparación con HBM3/4, su perfil de eficiencia y costo es ideal para la inferencia de contexto largo y servicios multiusuario. Esto garantiza que la serie D siga siendo viable para aplicaciones de cola larga y sensibles a la latencia donde el objetivo es maximizar la cantidad de solicitudes de usuario simultáneas en lugar de forzar un modelo masivo para terminar una época de entrenamiento en tiempo récord.
El veredicto definitivo
La GPU serie D de Intel es un producto calculado y realista que se alinea con el estado actual de la industria: una necesidad desesperada de hardware de inferencia eficiente y accesible. No es un "asesino de Nvidia" en el sentido de rendimiento puro, ni pretende serlo. En cambio, es una pieza esencial del rompecabezas para las empresas que no pueden, o no quieren, adoptar los requisitos extremos de refrigeración líquida de los chips de IA insignia actuales. Siempre que la pila de controladores y el ecosistema de software de Intel resistan una implementación en el mundo real, la serie D podría ser el acelerador más pragmático en la historia reciente de la compañía. Para las organizaciones que priorizan la escala de inferencia y el costo operativo, la serie D es altamente recomendada como un candidato principal de implementación.