Resumen ejecutivo y posicionamiento en el mercado
El panorama de los aceleradores de inteligencia artificial cambió drásticamente tras la transacción estructuralmente única de Nvidia de $20 mil millones que involucró al pionero en arquitectura de Unidades de Procesamiento de Lenguaje (LPU), Groq. En lugar de ejecutar una compra corporativa tradicional a gran escala, Nvidia estructuró un acuerdo híbrido que comprende una tarifa de licencia de $17 mil millones por la propiedad intelectual central de Groq, junto con un fondo de capital de $3 mil millones destinado a los aproximadamente 200 ingenieros que se transfirieron directamente a la división de hardware de Nvidia. Esta maniobra poco convencional, denominada "adquisición inversa de talento" por los reguladores, ha provocado un intenso escrutinio, culminando en una propuesta de demanda colectiva presentada en el Tribunal de Cancillería de Delaware por los exingenieros de Groq, Benjamin Serebrin y Joshua Rubin. Los demandantes alegan que la junta favoreció a ciertos patrocinadores de capital de riesgo mientras perjudicaba a los accionistas generales, una controversia agravada por las investigaciones activas del Departamento de Justicia y la Comisión Federal de Comercio.
Desde la perspectiva del posicionamiento en el mercado, el acuerdo permite a Nvidia integrar tecnología de inferencia determinista de latencia ultra baja directamente en sus estrategias de despliegue de centros de datos de alta gama. Los informes SEC 10-K de Nvidia revelan que aproximadamente $14.4 mil millones del capital de licencia se registraron como fondo de comercio, vinculado explícitamente a la fuerza laboral especializada y al desarrollo tecnológico a futuro, dejando solo $2.5 mil millones asignados directamente a los diseños de hardware fundamentales. Mientras tanto, la entidad residual de Groq ha girado agresivamente hacia servicios de IA basados en la nube, operando centros de datos y desplegando sus propias tecnologías bajo el nuevo marco Nvidia Groq 3 LPX. Esta maniobra legal y comercial de alto riesgo redefine cómo las empresas de billones de dólares adquieren talento de ingeniería y evitan los canales tradicionales de revisión antimonopolio, al mismo tiempo que consolida arquitecturas de silicio construidas específicamente para las fases de decodificación de modelos de lenguaje grande (LLM) a gran escala.
Innovaciones arquitectónicas y tecnológicas centrales
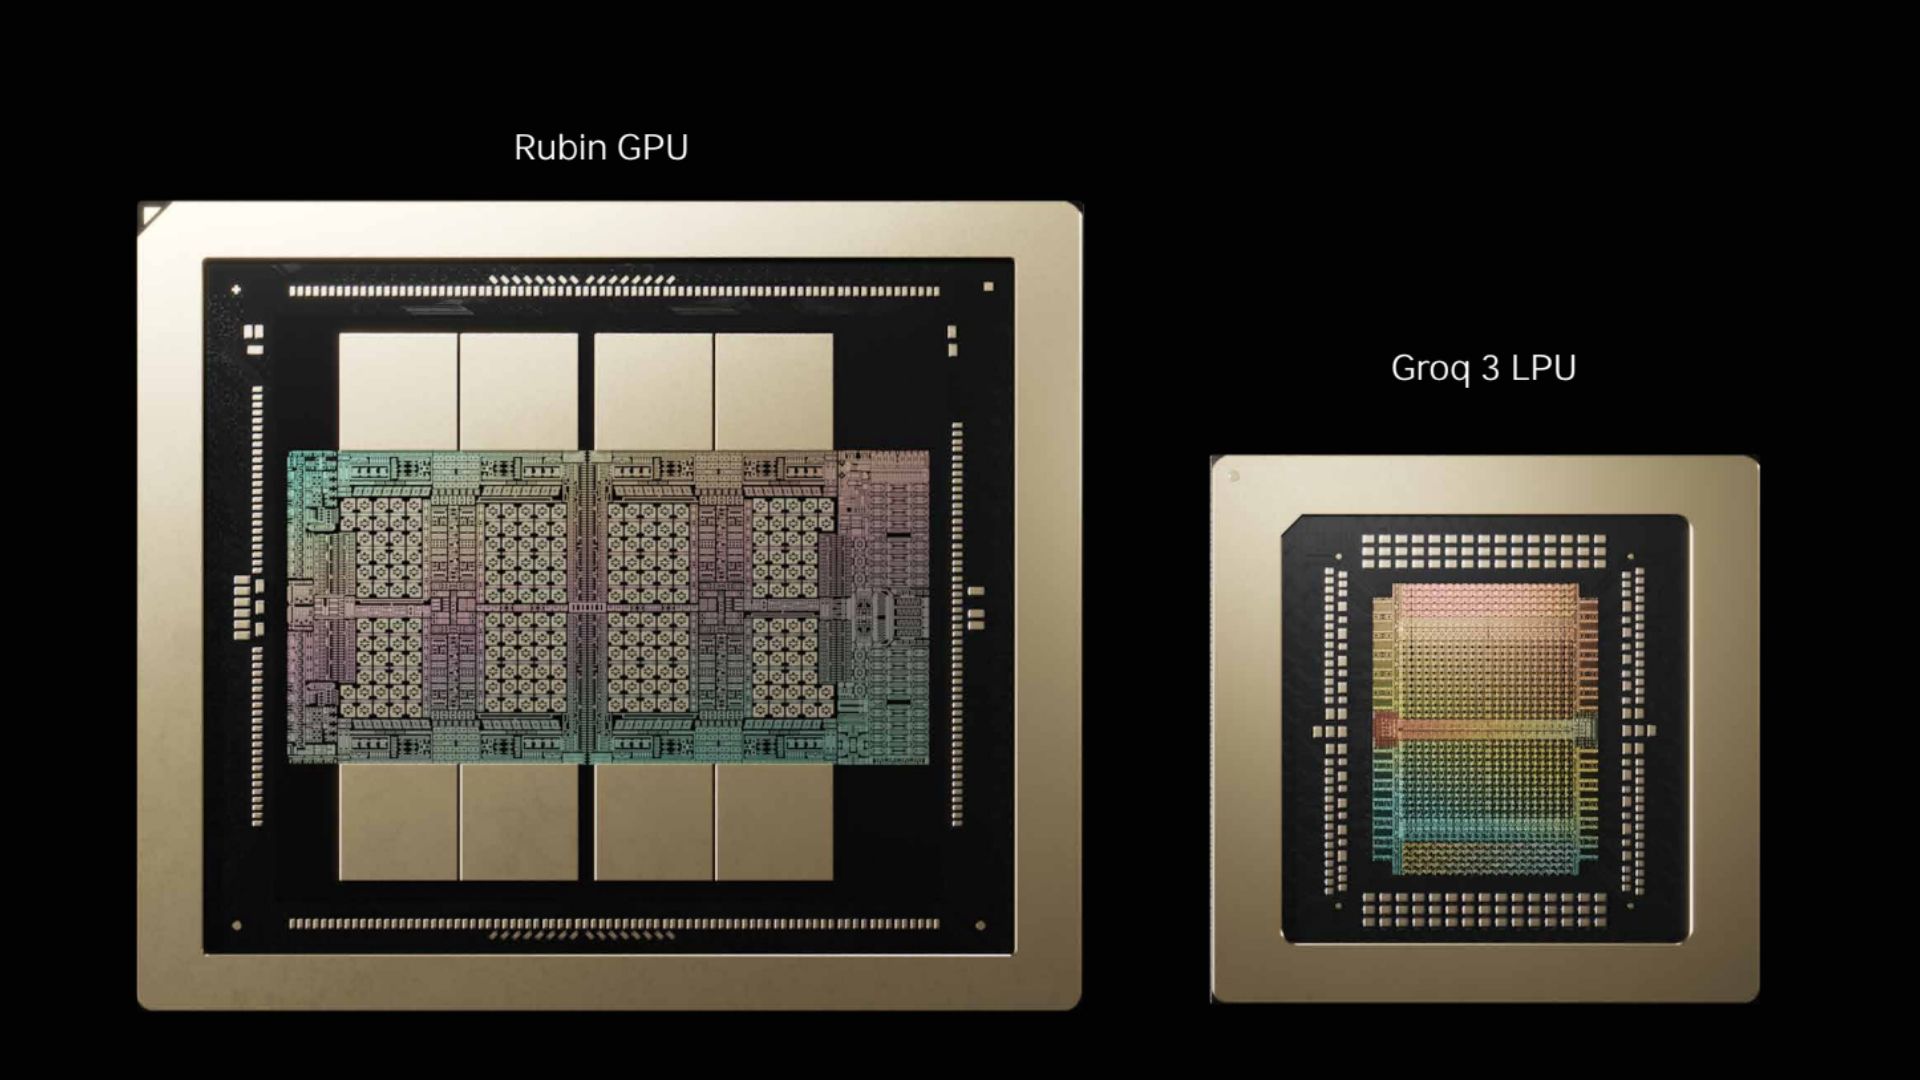
A nivel de silicio, el fruto de esta transacción se manifiesta en el Groq LP30, un motor de inferencia revolucionario construido sobre la avanzada tecnología de proceso de 4nm (SF4X) de Samsung. Diferenciándose fundamentalmente de las arquitecturas GPU tradicionales que dependen en gran medida de complejas jerarquías de caché y programación dinámica, la arquitectura Tensor Streaming de Groq aprovecha un modelo de ejecución determinista definido por software. Cada chip LP30 integra unos asombrosos 500 MB de SRAM de alto ancho de banda directamente en el chip, lo que permite un ancho de banda de memoria total masivo de 150 TB/s por chip. Esta filosofía de diseño elimina el cuello de botella de von Neumann inherente a los ciclos de búsqueda de HBM fuera del chip, convirtiendo a la LPU en un coprocesador de decodificación excepcionalmente eficiente cuando se combina con la próxima infraestructura Vera Rubin NVL72 de Nvidia.
Escalando este silicio a nivel de sistema, el rack Nvidia Groq 3 LPX consolida 256 LPU individuales en un único nodo de cómputo denso. Esta arquitectura colectiva produce 128 GB de SRAM distribuida en chip ultrarrápida, unos asombrosos 40 PB/s de ancho de banda de interconexión interna y una calificación de rendimiento agregado de 315 FP8 PFLOPS. Al funcionar como un coprocesador de decodificación especializado, la arquitectura LPX descarga las fases de generación de tokens limitadas por la memoria de los núcleos tensoriales primarios, acelerando drásticamente el tiempo hasta el primer token y el rendimiento de generación de tokens para cargas de trabajo de IA generativa masivas. Las iteraciones futuras del mapa de ruta, como el LP35 con soporte nativo para NVFP4 y el posterior LP40 diseñado para sistemas de generación Feynman, señalan que Nvidia tiene la intención de institucionalizar profundamente este modelo de ejecución determinista en toda su pila de centros de datos multigeneracionales.
Especificaciones empíricas y matriz de referencia
| Parámetro arquitectónico | Rack Groq LP30 / LPX | Nodo de inferencia GPU base (H100/B200) | Ventaja / Compensación |
|---|---|---|---|
| Nodo de proceso | Samsung 4nm (SF4X) | TSMC 4N / Clase 3nm | Mayor densidad de transistores vs. ecosistema de fundición maduro |
| Memoria en chip (SRAM) | 500MB por chip / 128GB por rack | Caché L2 limitada (~50MB - 100MB) | Capacidad masiva de memoria de trabajo determinista |
| Memoria externa | Centrada en SRAM (Sin dependencia HBM) | HBM3e / HBM4 (Hasta 8TB/s por GPU) | Elimina penalizaciones de latencia fuera del chip para inferencia |
| Ancho de banda agregado | 150 TB/s (Por chip) / 40 PB/s (Rack) | ~8 TB/s por nodo acelerador | Rendimiento de generación de tokens sin precedentes |
| Rendimiento de cómputo | 1.23 FP8 PFLOPS (LPU única) | Rendimiento variable de núcleos tensoriales FP8 | Optimizado explícitamente para etapas de decodificación determinista |
Térmica, eficiencia y ergonomía en el mundo real
Integrar 256 LPU junto con arreglos de SRAM masivos dentro de un espacio estándar de rack de servidor introduce serios desafíos de densidad térmica. A diferencia de los clústeres de GPU tradicionales donde la disipación térmica está dominada por pilas de HBM de alta potencia y chips de cómputo monolíticos masivos, la arquitectura Groq LPX distribuye las cargas térmicas entre numerosos chips más pequeños, pesados en SRAM y de alta frecuencia construidos sobre el nodo de 4nm de Samsung. Este perfil térmico distribuido requiere una integración de refrigeración líquida personalizada para mantener temperaturas de unión óptimas, particularmente cuando se opera dentro de centros de datos densos de más de 200 MW hacia los cuales Groq y sus socios en la nube se están escalando actualmente.
Desde el punto de vista de la eficiencia, la omisión de interfaces de memoria fuera del chip que consumen mucha energía (como HBM de múltiples pilas) genera ganancias de eficiencia sustanciales durante la fase de generación de tokens autorregresiva. Al mantener los conjuntos de trabajo activos completamente dentro del límite de 128 GB de SRAM agregada de un rack de 256 LPU, el consumo de energía dinámica por token generado cae precipitadamente en comparación con las arquitecturas tradicionales que buscan repetidamente los pesos en la DRAM externa. Los puntos de referencia de despliegue en el mundo real subrayan que este proceso determinista minimiza las latencias de cola, garantizando SLA operativos predecibles para proveedores de nube de IA empresariales como Nebius y socios de integración de Dell que escalan clústeres de inferencia de producción.
El veredicto definitivo
La transacción de $20 mil millones de Nvidia por Groq se destaca como una clase magistral en la adquisición de ingeniería corporativa moderna, eludiendo con éxito los bloqueos estándar de fusiones mientras captura el talento de LPU determinista y la propiedad intelectual más importante de la industria. Arquitectónicamente, la plataforma resultante Groq 3 LPX y su silicio subyacente LP30 representan un salto monumental en la eficiencia de la generación de tokens autorregresivos, demostrando que los modelos de ejecución definidos por software y centrados en SRAM poseen un papel permanente y crítico en los despliegues de IA a hiperescala de próxima generación. Sin embargo, la sombra de las investigaciones activas del Departamento de Justicia y el litigio de accionistas no resuelto en Delaware inyecta una volatilidad regulatoria persistente en el horizonte comercial a largo plazo del hardware. Para los compradores empresariales y arquitectos de la nube, el rendimiento del hardware es innegablemente de élite; para el mercado de semiconductores en general, este acuerdo establece un precedente polémico que remodelará permanentemente la forma en que se adquieren la propiedad intelectual y los equipos de ingeniería de élite.