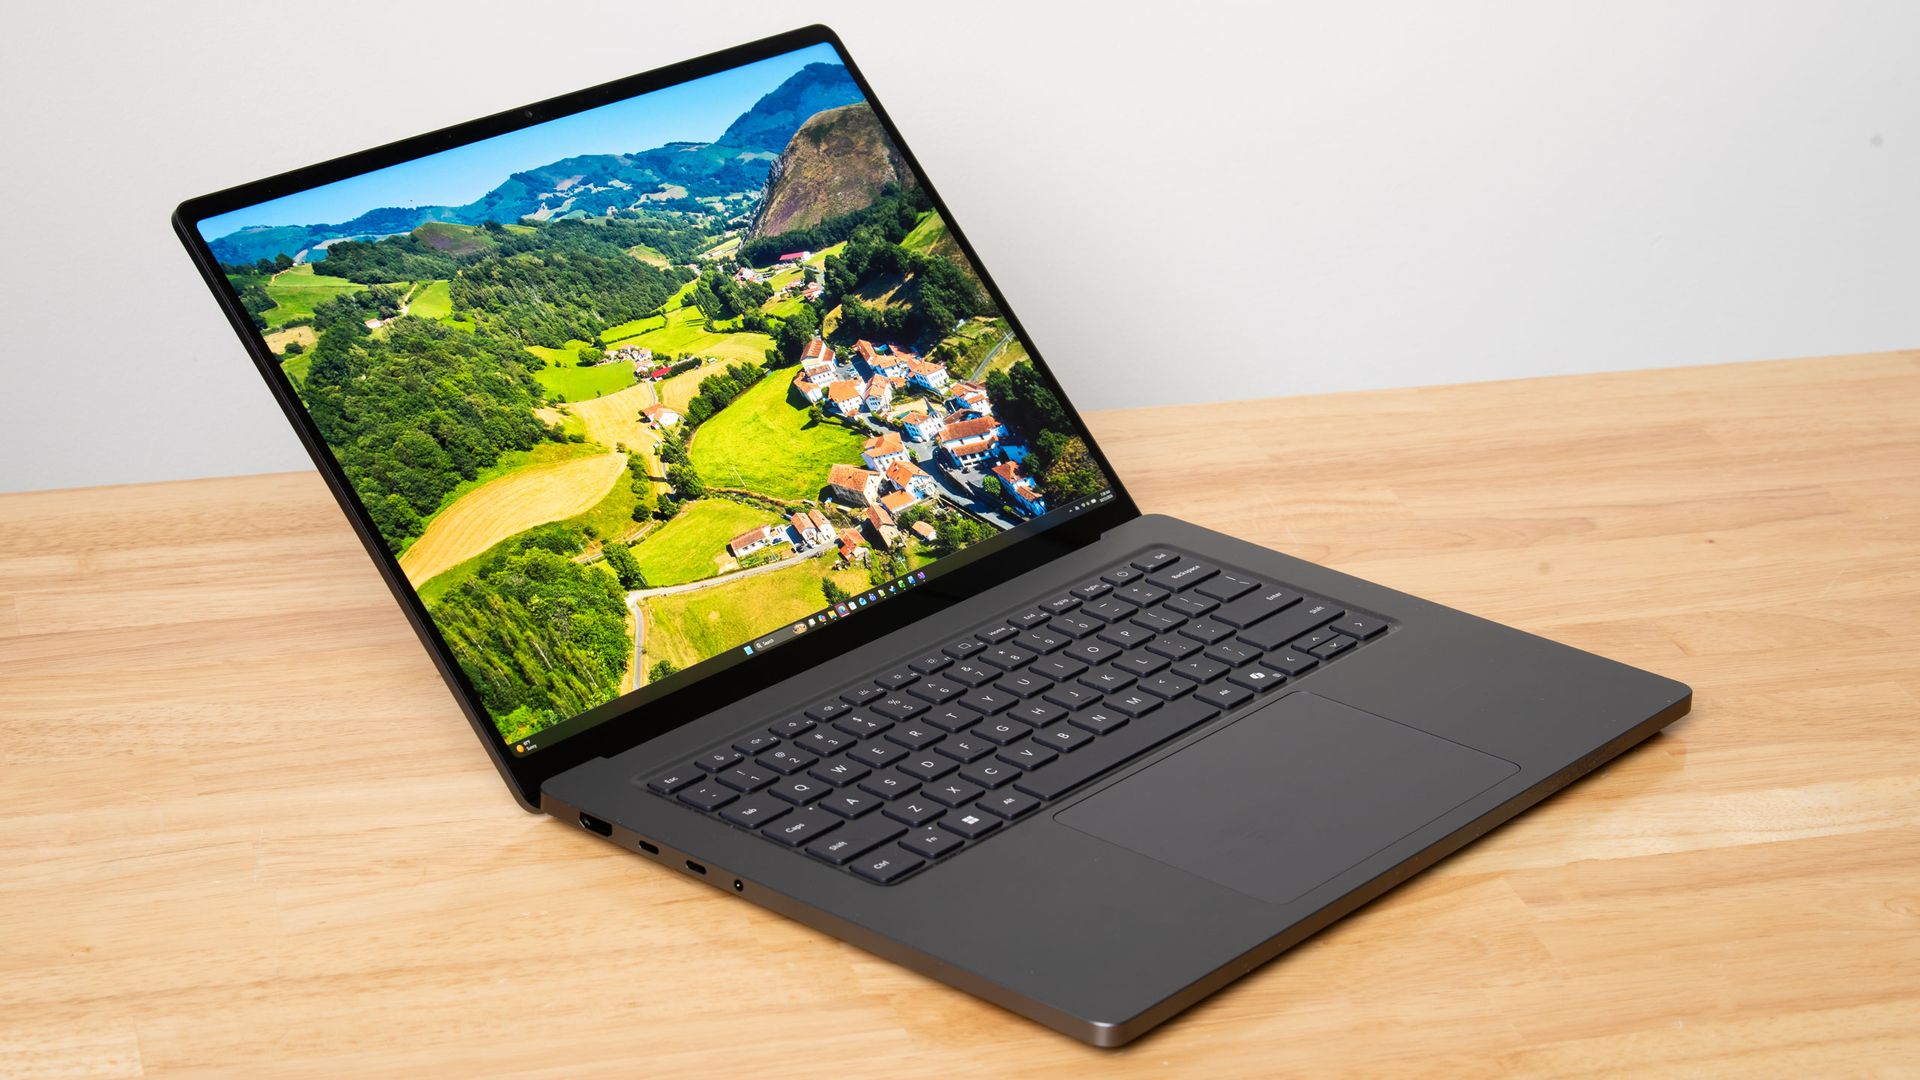
Zusammenfassung & Marktpositionierung
Das Computer-Paradigma verlagert sich rasant von der Ausführung statischer Software hin zu dynamischen, autonomen agentenbasierten Arbeitsabläufen. Nvidias Einführung der RTX Spark-Plattform, verankert durch den GB10-Superchip, stellt einen kalkulierten Versuch dar, die Architektur mobiler PCs neu zu erfinden. Bewertet im Top-Modell Microsoft Surface Laptop Ultra – ausgestattet mit 128 GB LPDDR5X-9400 RAM – richtet sich dieser Hardware-Stack an professionelle Anwender, Enterprise-Betreiber und Entwickler schwerer lokaler KI-Anwendungen. Nvidias strategisches Ziel ist klar: Rechenzentrumstaugliche Inferenz- und Parallelverarbeitungsfunktionen in ein schlankes, tragbares Chassis zu integrieren.
Diese ambitionierte Hardware-Konvergenz offenbart jedoch spürbare generationsspezifische Startschwierigkeiten. Während die Grenzen der lokalen KI-Ausführung durch die massiv parallele Architektur des Spark grundlegend neu definiert werden, zeichnen traditionelle, lokalisierte Workloads und die Reife des Software-Ökosystems ein nuancierteres Bild. Direkt positioniert gegen Apples M5 Max-Silizium und die Ryzen AI Halo-Systeme von AMD, schärft die RTX Spark-Plattform ein unverwechselbares operatives Profil. Sie opfert rohe CPU-Rechenleistung und Gaming-Stammbäume zugunsten einer beispiellosen End-to-End-Geschwindigkeit bei der Bewältigung agentenbasierter Aufgaben und setzt damit einen neuen Maßstab dafür, was lokale neurale Hardware in einem mobilen Formfaktor leisten kann.
Kernarchitektur & Technische Innovationen
Auf Siliziumebene setzt die RTX Spark-Plattform auf ein heterogenes Design, das einen 20-Core-CPU-Komplex (mit Kernen auf Basis der MediaTek-Arm-Architektur) mit einer gewaltigen GPU aus 6.144 CUDA-Kernen und 48 Streaming-Multiprozessoren paart. Dieses Layout ist speziell optimiert für die Ausführung lokalisierter Transformer, spekulative Dekodierungsverfahren wie DFlash2 und Multi-Token-Prediction-Pipelines (MTP). Durch die direkte Integration von 128 GB ultraschnellem LPDDR5X-9400-Speicher in das Unified-Memory-Subsystem umgeht Nvidia traditionelle PCIe-Bandbreitenengpässe, die die Ausführung großer Sprachmodelle (LLMs) auf Client-Hardware in der Vergangenheit oft behinderten.
Trotz dieser architektonischen Triumphe offenbart die rohe CPU-Leistung die aktuelle Achillesferse der Plattform. In Single-Core- und Multi-Core-Geekbench-Evaluierungen hinkt der von MediaTek bezogene Arm-CPU-Komplex Apples M5 Max-Silizium sichtbar hinterher. Der Spark wirkt bei alltäglicher Desktop-Navigation oder grundlegenden Produktivitätsaufgaben keineswegs träge, doch rechenintensive Kompilierungen und serialisierte, CPU-gebundene Berechnungen offenbaren ein Leistungsdefizit im Vergleich zu ausgereifteren Architekturen. Wenn man ihm jedoch komplexe lokalisierte Intelligenzmodelle wie das dichte Qwen 3.8-27B oder das Qwen 3.6 35B A3B Mixture-of-Experts übergibt, entfesselt das CUDA-Kern-Layout einen massiven parallelen Datendurchsatz, wodurch CPU-Diskrepanzen bei agentenbasierten Aufgaben vernachlässigbar werden.
Empirische Spezifikationen & Benchmark-Matrix
| Merkmal / Metrik | Nvidia RTX Spark (Surface Laptop Ultra) | Apple M5 Max (14" MacBook Pro) | AMD Ryzen AI Halo (Strix Halo) | Architektonischer Vorteil / Notizen |
|---|---|---|---|---|
| CPU-Kernanzahl | 20 Kerne (Arm-basiert) | 18 Kerne (Apple Silicon) | Zen 5 + XDNA 2 Engine | Apple führt bei roher Single-/Multi-Thread-CPU-IPC. |
| GPU-Recheneinheiten | 6.144 CUDA-Kerne (48 SMs) | 40-Core GPU / Metal | Integrierte RDNA 3.5 | Nvidia dominiert bei roher paralleler Vektorbeschleunigung. |
| Systemarbeitsspeicher | 128 GB LPDDR5X-9400 | 128 GB LPDDR5X | Bis zu 128 GB Unified | Hohe Bandbreite ist essenziell für MoE- und dichte LLMs. |
| AgentPerf-local (27B) | Am schnellsten (ca. 25 % schneller als Mac) | Konkurrenzfähig, speichergebunden | ~40 Minuten (Signifikant langsamer) | Die Spark-Architektur minimiert die End-to-End-Agentenlatenz. |
| AgentPerf-local (35B) | 8 Minuten Abschlusszeit | 10 Minuten Abschlusszeit | 13 Minuten Abschlusszeit | Zeigt überlegenen Token-Generierungsdurchsatz. |
Thermik, Effizienz & Ergonomie im Praxiseinsatz
Die Analyse des thermischen und elektrischen Profils des Surface Laptop Ultra offenbart die aggressive Abstimmung, die erforderlich ist, um die RTX Spark-Plattform zu betreiben. Über ein kräftiges 140-W-Netzteil mit Strom versorgt – entsprechend der Leistungsklasse größerer 16-Inch-MacBooks – nutzt dieses 15-Inch-Gehäuse die thermischen Spielräume voll aus. Zwar ist die Erstellung umfassender Akkulaufzeit-Profile durch aktuelle Embargo-Einschränkungen noch eingeschränkt, doch das thermische Design priorisiert ganz klar eine dauerhafte Rechenleistung gegenüber passiver, lüfterloser Effizienz.
Bei der Ausführung anspruchsvoller Agenten-Workloads über die AgentPerf-local-Suite von Artificial Analysis hält die Hardware das thermische Gleichgewicht effektiv und vermeidet extremes Thermal Throttling. Das System schloss den Inferenzdurchlauf des dichten Qwen 3.8-27B-Modells 25 % schneller ab als das 14-Inch M5 Max MacBook Pro – ein Erfolg, der teilweise dem großzügigen Leistungslimit und dem aktiven Kühldesign des Surface-Gehäuses zu verdanken ist. Umgekehrt benötigte das kompakte Desktop-Äquivalent von AMD (Ryzen AI Halo) etwa die doppelte Laufzeit, um identische Agenten-Workloads zu bewältigen, was unterstreicht, dass rohe architektonische Effizienz und kontinuierliche Stromversorgung für die professionelle KI-Ausführung unverzichtbar sind.
Das definitive Fazit
Nvidias RTX Spark-Plattform im Microsoft Surface Laptop Ultra ist ein Triumph spezialisierter Hardware-Entwicklung für das KI-Zeitalter. Sie erobert entscheidend die Krone für die lokale Ausführung von Agenten-Aufgaben und übertrifft Apples M5 Max und AMDs Strix Halo bei komplexen, mehrstufigen LLM-Inferenz-Benchmarks wie AgentPerf-local. Für Entwickler, Data Scientists und Power-User, deren tägliche Arbeit von der schnellen Ausführung lokaler Modelle und autonomer Agenten-Produktivität abhängt, rechtfertigt die Spark-Architektur ihre Premium-Hardware-Positionierung.
Dies ist jedoch kein universelles Allheilmittel für Verbraucher. Die von MediaTek stammenden CPU-Kerne der Plattform hinken konkurrierenden Architekturen bei der rohen Rechenleistung hinterher, und das noch junge Software-Ökosystem rund um die Plattform erfordert kontinuierliche Verfeinerungen. Darüber hinaus bleibt die traditionelle Gaming-Leistung trotz des starken RTX-Brandings und der enormen CUDA-Kernanzahl eine sekundäre, unterentwickelte Stärke – was bedeutet, dass potenzielle Käufer dieses System durch die Brille der Enterprise-Produktivität statt aus einer Konsum-Unterhaltungsperspektive bewerten müssen. Letztendlich erfindet der RTX Spark die professionelle PC-Workstation erfolgreich neu, vorausgesetzt, Ihre Definition von Arbeit dreht sich ausschließlich um künstliche Intelligenz.