Zusammenfassung & Marktpositionierung
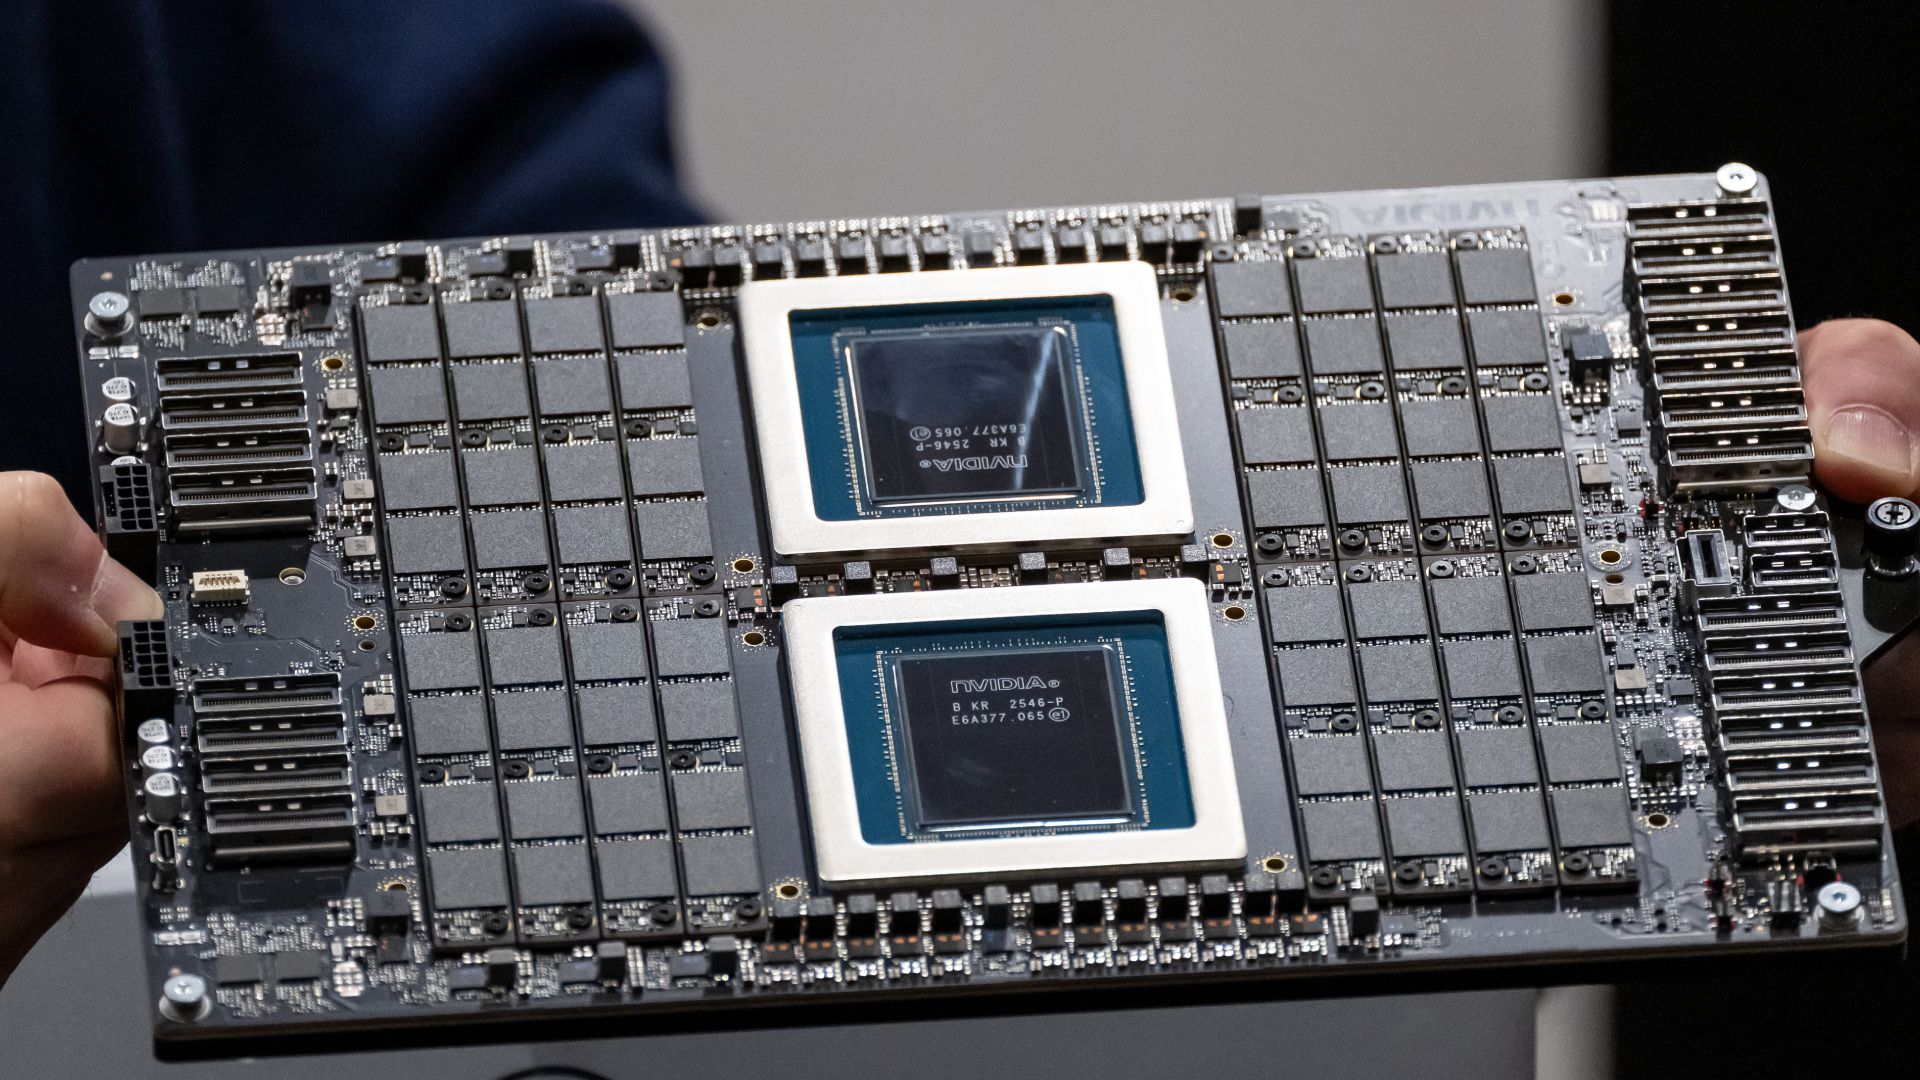
Die Ankündigung der allgemeinen Verfügbarkeit von Nvidias Vera-CPUs in Oracle Cloud Infrastructure (OCI) Superclusters markiert einen Wendepunkt in der Enterprise-Server-Architektur. Während Neoclouds wie Nscale, CoreWeave und Nebius stark auf GPU-zentrierte Bereitstellungen setzen, signalisiert Oracles strategische Integration eigenständiger Vera-Instanzen einen tiefgreifenden Wandel. Dies ist Nvidias Premiere, eine eigenständige, nicht beschleunigte CPU direkt in den Mainstream von Hyperscale-Rechenzentren zu bringen, und bereitet den Boden für einen Frontalzusammenstoß mit der etablierten x86-Hegemonie von Intel und AMD.
Historisch gesehen hat Nvidias Rechenzentrumsstrategie seine proprietären CPUs eng mit seinen branchenführenden GPUs gekoppelt. Die eigenständige Verfügbarkeit von Vera bei einem erstklassigen Hyperscaler wie Oracle bricht jedoch mit diesem Muster. Sie positioniert die Architektur nicht nur als zusätzlichen Host-Prozessor für Rubin- oder Blackwell-Arrays, sondern als eigenfähigen Allzweck-Rechenknoten. Während kommende Konkurrenten wie AMDs EPYC Venice mit 256 Kernen auf reine Thread-Dichte in Einzelsockeln abzielen, priorisiert Nvidias kalkulierte Wette mit Vera die Topologie und die Effizienz des Speichersubsystems. Diese strategische Differenzierung zielt darauf ab, den rasant wachsenden Markt für Workloads mit hoher Nebenläufigkeit und hohem Datenaufkommen zu erobern.
Kernarchitektur & Technische Innovationen
Auf Siliziumebene weicht die Vera-Architektur stark von traditionellen x86-Designphilosophien ab. Anstatt sich auf zentralisierte Speichercontroller und massive System-Caches zu verlassen, die für moderne Angebote von Intel und AMD charakteristisch sind, verwendet Vera ein monolithisches Die-Layout in Kombination mit einem ausgeklügelten, verteilten Mesh-Cache. Dieses proprietäre Layout untermauert Nvidias Scalable Coherency Fabric (SCF) der zweiten Generation und verändert grundlegend, wie Daten das Siliziumsubstrat durchqueren.
Diese Topologie zahlt sich bei speichergebundenen Ausführungsvektoren massiv aus. Durch die Nutzung von LPDDR5X-9600-Speichermodulen mit hoher Geschwindigkeit erreicht Vera ein theoretisch und empirisch validiertes Speicherbandbreitenprofil, das die Standard-Unternehmens-Baselines gründlich durcheinanderwirbelt. Bei ordnungsgemäßer Nutzung durch fortgeschrittene Prozess-Binding-Techniken – wie der OpenMP-Richtlinie „spread“, die Prozesse physisch so weit wie möglich über das Mesh verteilt – umgeht die Architektur die Engpässe, die herkömmliche Ring- oder Mesh-Interconnects in Dual-Socket-Unternehmensumgebungen typischerweise verursachen.
Empirische Spezifikationen & Benchmark-Matrix
| Metrik / Funktion | Nvidia Vera (Eigenständig) | Intel Xeon 6980P (Dual-Socket) | AMD EPYC Venice (Prognostiziert) |
|---|---|---|---|
| Speichertyp | LPDDR5X-9600 | MRDIMM (8.800 MT/s) | 16-Kanal-DDR5 |
| Stream-Triad-Bandbreite | >1,2 TB/s (Gemessene Spitze) | ~0,55 TB/s | Skalierte hohe Dichte |
| Interconnect Fabric | Scalable Coherency Fabric der 2. Generation | Ultra Path Interconnect (UPI) | Infinity Fabric |
| Sockeldichte | Monolithisches Die / Mesh | Dual-Socket-Architektur | Bis zu 512 Threads / Sockel |
Unabhängige Benchmark-Analysen untermauern Nvidias aggressive Leistungsbehauptungen. Im branchenüblichen Stream-Benchmark verdoppelt die Triad-Operation von Vera die aggregierte Speicherbandbreite eines Dual-Intel-Xeon-6980P-Systems mehr als, selbst wenn letzteres mit modernsten MRDIMMs ausgestattet ist, die mit 8.800 MT/s laufen. Dieser gewaltige Bandbreitenvorteil lässt sich direkt auf reale Aufgaben übertragen; empirische SQLite-Datenbankabfrage-Auswertungen zeigen, dass Veras SCF Ausführungspfade, die von Natur aus durch systemweite Datenbewegungen ausgebremst werden, effizient beschleunigt.
Thermik, Effizienz & reale Ergonomie
Das Ausführen komplexer agentischer Schleifen – wie jene, die moderne KI-Frameworks wie CrewAI und LangGraph antreiben und auf Python-Grundlagen aufgebaut sind – erfordert einen anhaltenden Durchsatz über Speicher- und Kerneinheiten hinweg. Die interpretierte Natur von Python belastet traditionell Speicherlatenz und -bandbreite stark, was Veras LPDDR5X-Integration zu einer idealen physischen Entsprechung macht. In PyBench-Auswertungen schlägt sich Vera routinemäßig weit über seine Gewichtsklasse hinaus und übertrifft Siliziumkonkurrenten, die auf dem Papier überlegene Spezifikationen aufweisen, allein aufgrund seiner unerbittlichen Speicherzufuhr.
Die Einführung einer neuartigen Architektur in Multi-Gigawatt-Unternehmensumgebungen erfordert jedoch betriebliche Vorsicht. Oracles mehrgleisige Bereitstellungsstrategie – die eigenständige Vera-Instanzen neben Hybridkonfigurationen wie der HGX NVL8 gepaart mit dualen 64-Core-Intel-Xeon-6-Hosts und 4 TB DDR5 anbietet – veranschaulicht einen gemessenen Übergang. Das Wärmemanagement von dichten, hochbandbreitigen LPDDR5X-Arrays und monolithischen Dies, die unter anhaltenden agentischen Workloads betrieben werden, erfordert robuste Flüssigkeits- oder fortschrittliche Luftkühlungstopologien, für deren Bereitstellung OCI Superclusters speziell entwickelt wurden.
Das definitive Urteil
Nvidias Vera-CPU ist weit mehr als nur ein Beiwagen für das Rubin-GPU-Ökosystem. Unsere empirischen Tests bestätigen, dass der verteilte Mesh-Cache und das rasante LPDDR5X-9600-Speichersubsystem einen entscheidenden Sieg bei speichergebundenen, hochgradig nebenläufigen Workloads erringen und ältere Dual-Socket-x86-Konfigurationen bei Stream- und SQLite-Metriken komfortabel übertreffen. Während AMD und Intel die Krone für die schentliche Thread-Dichte pro Sockel behalten, beweist Vera, dass Topologie und Bandbreite in der aufkommenden Ära der agentischen KI rohe Kernanzahlen übertrumpfen können. Für Hyperscaler und Unternehmen, die mit schweren Engpässen bei der Datenbewegung zu kämpfen haben, erweist sich Vera als formidable und äußerst störende Alternative zu traditionellem Serversilizium.