Executive Summary & Marktpositionierung
Aktuelle Finanzberichte deuten darauf hin, dass SpaceX aktiv ein massives Schuldenpaket in Höhe von 40 Milliarden US-Dollar für das Jahr 2027 vorbereitet, das primär für die Beschaffung von KI-Prozessoren der nächsten Nvidia-Generation vorgesehen ist. Während Unternehmensstrukturen diese Initiative formal durch das breitere Ökosystem von Elon Musk leiten, zielt der operative Gewinn auf die Hyperscale-Rechencluster von xAI ab. Das vorgeschlagene Finanzinstrument kombiniert Berichten zufolge 10 Milliarden Dollar an direkten Bankkrediten mit 30 Milliarden Dollar an Anleihen mit Investment-Grade-Rating, wobei Finanzgrößen wie Apollo Global Management und Pimco angeblich bei der Strukturierung federführend sind. Diese beispiellose Kapitalinjektion unterstreicht einen grundlegenden Wandel bei der Beschaffung von Hyperscale-Infrastruktur: weg von traditionellem Risikokapital und Unternehmens-Cashflows hin zu Schuldtiteln in staatlicher Größenordnung.
Aus Sicht der Marktpositionierung sprengt dieser Aufwand historische Präzedenzfälle für Hardware-Beschaffungszyklen einzelner Einheiten. Aufbauend auf den bisherigen Implementierungen von xAI – wie den Colossus-Cluster-Iterationen, die Hunderttausende von Beschleunigern mit Blackwell-Architektur nutzen – lässt sich der Zeitplan für 2027 direkt auf die kommende Vera-Rubin-Generation von Nvidia übertragen. Indem xAI Milliarden für dedizierte Hardware-Finanzierungen Jahre im Voraus bindet, versucht das Unternehmen, der globalen Silizium-Knappheit zuvorzukommen, Zuteilungen bei Tier-1-Foundries zu sichern und einen aggressiven Kurs im Wettrüsten um generative KI-Grundlagenmodelle beizubehalten. Diese Strategie behandelt fortschrittliches Silizium nicht nur als Investitionsaufwand, sondern als strategisches Hauptvermögen, vergleichbar mit schwerer Industrieinfrastruktur.
Zentrale architektonische & technologische Innovationen
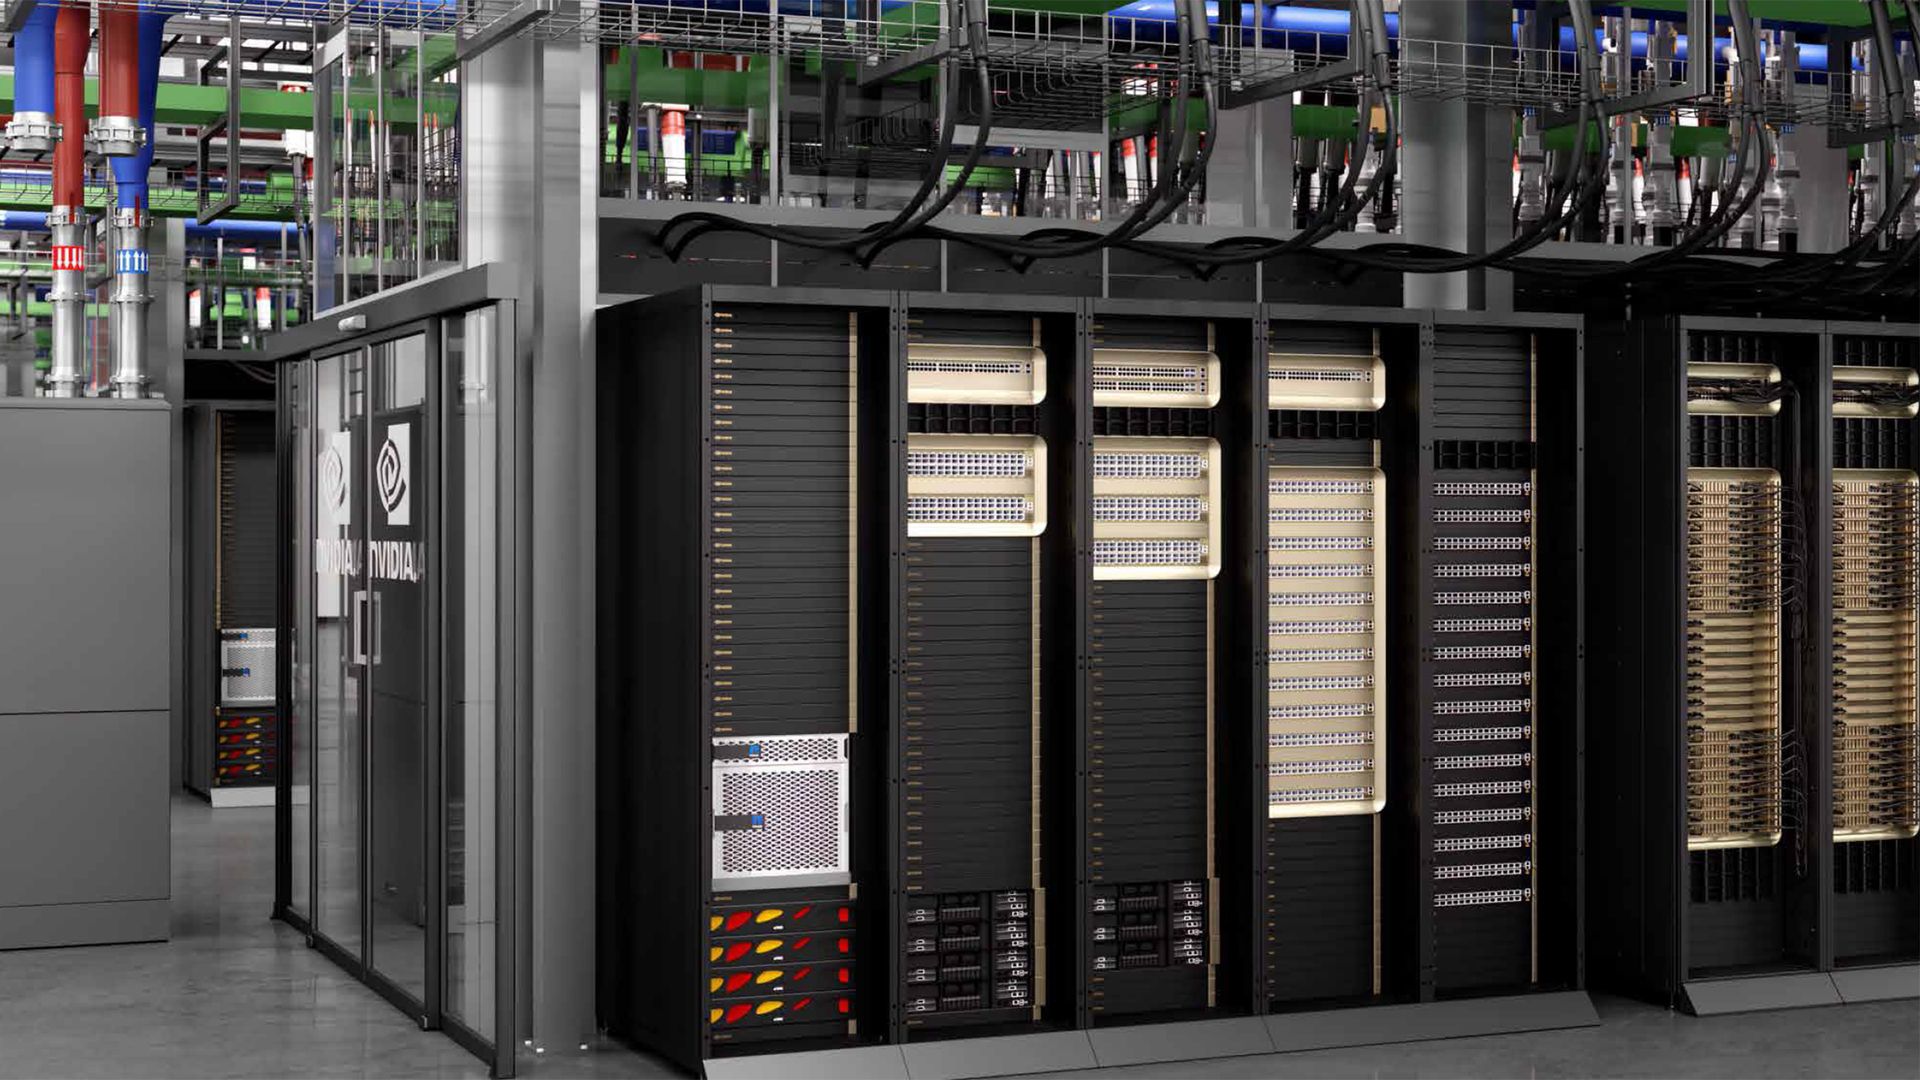
Der technologische Anker dieser geplanten 40-Milliarden-Dollar-Investition ist die kommende Vera-Rubin-Architektur von Nvidia, deren Einsatz insbesondere in Rack-Scale-Konfigurationen ähnlich dem Rubin NVL72 erwartet wird. Über die architektonischen Paradigmen von Hopper und Blackwell hinaus führt die Rubin-Generation umfassende Überarbeitungen der Verhältnisse von Rechenleistung zu Speicher, die Integration optischer Verbindungen und proprietäre NVLink-Switch-Fabrics ein. Mit astronomischen Bewertungen für einzelne Racks – geschätzt auf rund 8,8 Millionen Dollar pro NVL72-Einheit – repräsentiert die Hardware das absolute technologische Limit dichter heterogener Datenverarbeitung. Jedes Rack integriert maßgeschneiderte Prozessoren, fortschrittlichen High-Bandwidth Memory (HBM4) und Co-Design-Silizium, das für massive transformerbasierte Inferenz- und Trainingslasten optimiert ist.
Im Makromaßstab bedeutet die Zuweisung von 40 Milliarden Dollar auf das Rubin NVL72-Ökosystem etwa 5.000 vollständig integrierte Racksysteme, die rund 360.000 einzelne Nvidia Rubin KI-Beschleuniger beherbergen. Diese Dichte verändert die Anforderungen an die Topologie von Rechenzentren drastisch. Im Gegensatz zu traditionellen Serverbereitstellungen, bei denen Knoten schrittweise aus unterschiedlichen Mainboards und Schnittstellenkarten zusammengesetzt werden, behandelt der Rubin-Rack-Scale-Ansatz das gesamte 72-GPU-Chassis als eine einzige monolithische Rechenmaschine. Dies minimiert Latenzengpässe, maximiert die Bandbreite innerhalb des Racks durch optische Multi-Terabit-Transceiver-Arrays und optimiert die komplexe Orchestrierung, die für das Training von KI-Modellen der Spitzenklasse erforderlich ist, ohne durch netzwerkbedingte Engpässe ausgebremst zu werden.
Empirische Spezifikationen & Benchmark-Matrix
| Hardware-Metrik | Nvidia Blackwell GB200 (Basis) | Nvidia Vera Rubin NVL72 (Prognose) | Architektonisches Delta |
|---|---|---|---|
| Prozessknoten | TSMC 4NP Custom | Fortschrittliche N3 / N2-Klasse | Höhere Transistordichte & geringere Leckströme |
| Speicherstandard | HBM3e (bis zu 192GB/pkg) | HBM4 (erweiterte Kapazität/Busbreite) | Exponentiell höhere Speicherbandbreite |
| Interconnect-Bandbreite | 1,8 TB/s bidirektional pro GPU (NVLink) | Next-Gen NVLink Switch Fabric | Reduzierte Latenz, höhere Skalierungseffizienz |
| Geschätzte Stückkosten | ~3 Mio. – 4 Mio. $ pro Rack-Äquivalent | ~8,8 Mio. $ pro NVL72-Rack | Reflektiert Integrationsmaßstab & HBM4-Aufschläge |
| Zielbereitstellung | 2024–2025 (Colossus-Iterationen) | 2027 (xAI Zielzeitfenster) | Trainingskapazität der nächsten Generation |
Thermik, Effizienz & Praxis-Ergonomie
Der Einsatz von etwa 360.000 Rubin-Beschleunigern über 5.000 Racks hinweg stellt beispiellose thermodynamische und facility-technische Herausforderungen dar. Da die Leistungsdichte einzelner Racks weit über 100 Kilowatt steigt – und je nach Taktraten und Lastintensität potenziell die 150kW-Grenze erreicht – ist Luftkühlung für diese Hardwareklasse völlig unzureichend. Einrichtungen für den xAI-Rollout werden sich vollständig auf fortschrittliche Liquid-to-Chip-Kühlkreisläufe, präzise Kühlmittelverteiler (CDMs) und hochleistungsfähige Sekundärwärmetauscher verlassen müssen. Das Thermomanagement muss strikte Sperrschichttemperaturen einhalten, um thermische Drosselung zu verhindern und monatelange, unterbrechungsfreie Trainingsläufe zu gewährleisten.
Die Energieversorgung ist ebenso anspruchsvoll. Der Betrieb von 5.000 dichten Racks erfordert dedizierte Infrastruktur im Megawatt-Bereich, robuste Batteriespeichersysteme (BESS) zur Netzstabilisierung und redundante unterbrechungsfreie Stromversorgungen (USV), um Mikro-Ausfälle abzufedern, die andernfalls während massiver Trainingsläufe aktive Checkpoint-Zustände beschädigen könnten. Die Effizienzgewinne der fortschrittlichen Lithographieknoten der Rubin-Architektur sind hier entscheidend; ohne dramatische Verbesserungen der Leistung pro Watt würde der reine Strombedarf bei einer Skalierung auf 360.000 Einheiten die praktischen Netzanschlussgrenzen üblicher Rechenzentren überschreiten, was Hyperscaler dazu zwingen würde, in direkter Nähe zu dedizierten Energiequellen zu bauen.
Das endgültige Urteil
Der kalkulierte Vorstoß von SpaceX und xAI für ein 40-Milliarden-Dollar-Schuldenpaket für Nvidia Rubin-Hardware ist ein risikoreiches, kapitalintensives Meisterstück der Infrastruktur-Dominanz. Finanziell ermöglicht die Nutzung von Fremdkapital über Institutionen wie Apollo und Pimco dem Unternehmen, sich Rechenleistung für Generationen zu sichern, ohne das Eigenkapital vorzeitig zu verwässern. Technologisch positioniert der Einsatz von etwa 5.000 Vera Rubin NVL72-Systemen xAI an der absoluten Spitze der weltweiten KI-Leistungsfähigkeit und liefert die rohen FLOPS und die Speicherbandbreite, die erforderlich sind, um Wettbewerber zu überholen, die durch konventionelle Investitionsmodelle eingeschränkt sind.
Empfehlung: Für institutionelle Analysten und Hardware-Ingenieure gleichermaßen signalisiert dieser Schritt, dass das Rennen um die KI-Infrastruktur in eine industrielle Phase eingetreten ist, in der der Zugang zu Fremdkapitalmärkten und fortschrittlichem Rack-Scale-Silizium über die Marktführerschaft entscheidet. Obwohl das finanzielle Risiko gewaltig ist, stellen die technologischen Dividenden der Sicherung von 360.000 Rubin-Beschleunigern sicher, dass der Rechenleistungs-Burggraben von xAI bis in die späten 2020er Jahre hinein praktisch uneinnehmbar bleiben wird.