Zusammenfassung & Marktpositionierung
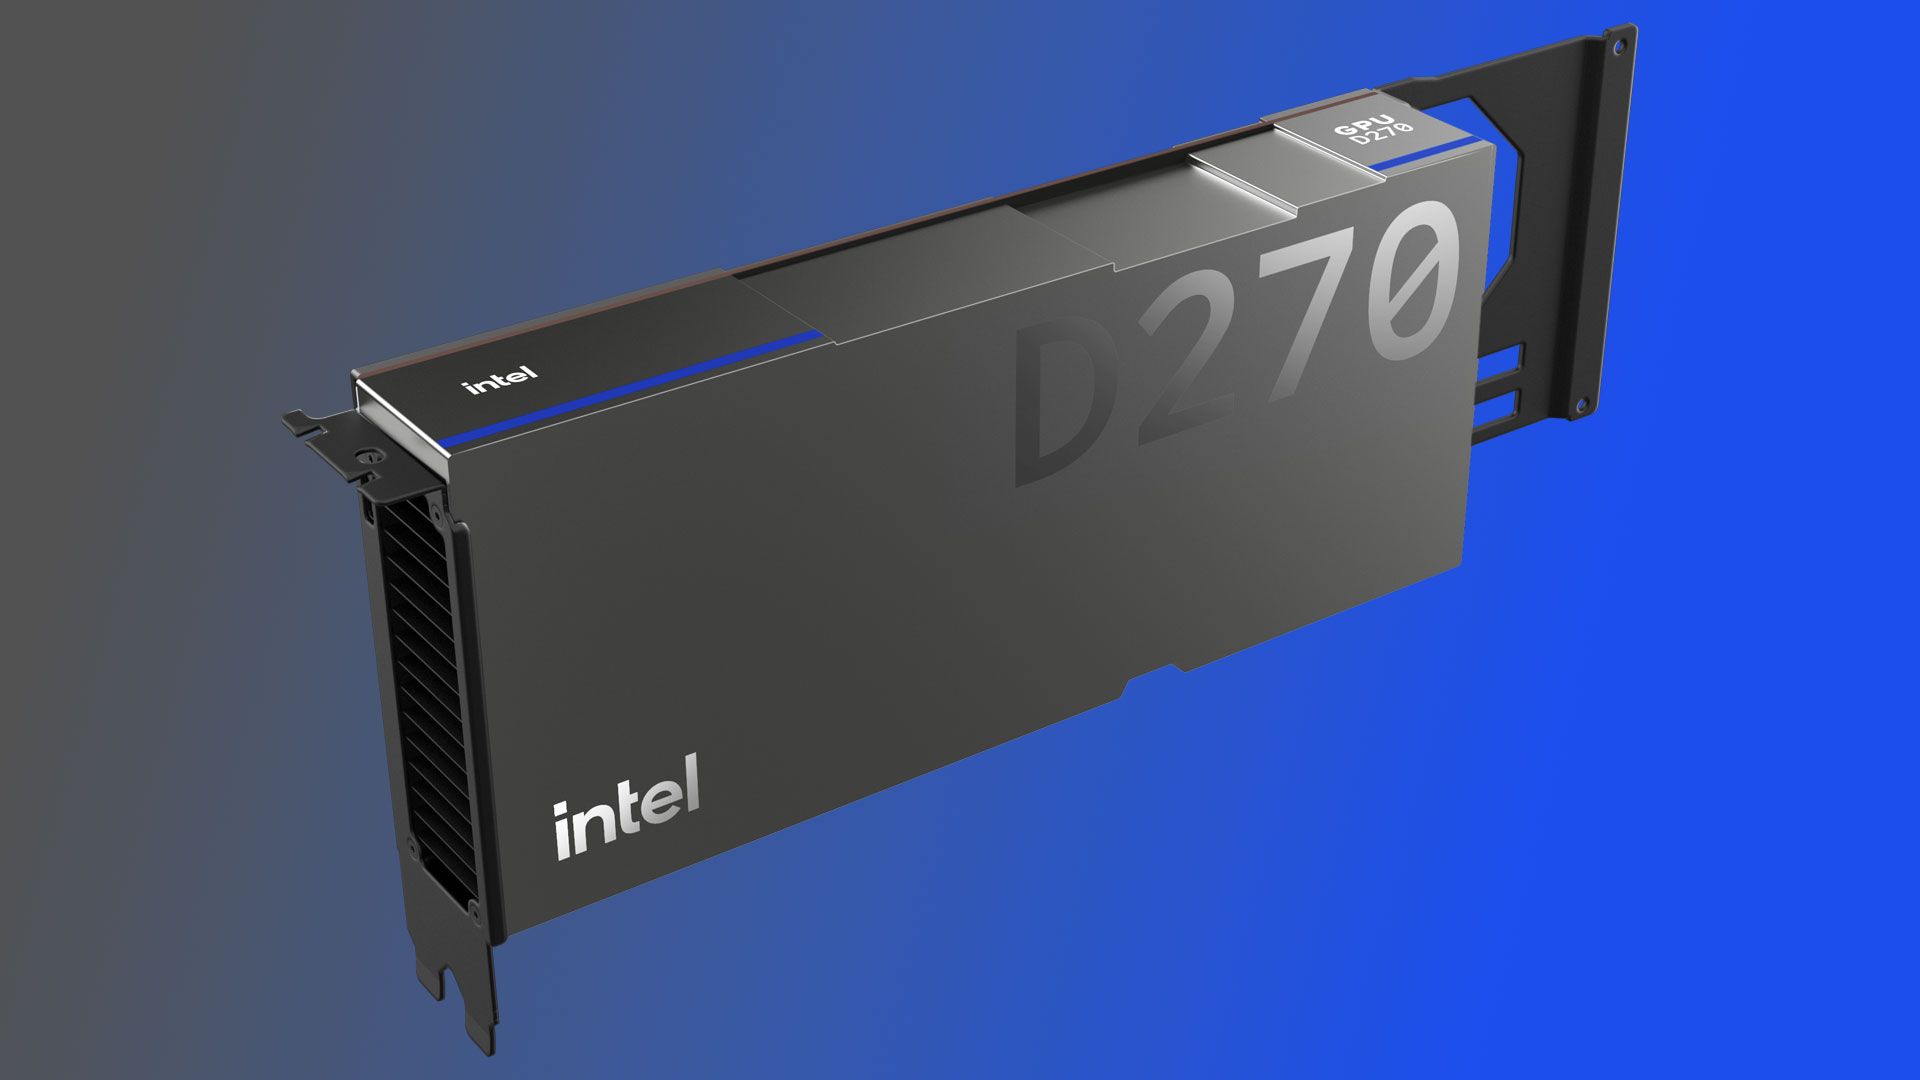
Intels formelle Enthüllung der GPU D-Serie – früher unter dem Codenamen „Crescent Island“ bekannt – stellt eine entscheidende strategische Neuausrichtung für die Rechenzentrumsambitionen des Unternehmens dar. Nach der turbulenten Performance der Data Center GPU Max (Ponte Vecchio) und der anschließenden Auflösung der breiteren High-End-Beschleuniger-Roadmaps signalisiert die GPU D-Serie eine Abkehr vom direkten Wettbewerb mit Nvidias ultra-high-end H100/Rubin-Flaggschiffen. Stattdessen positioniert Intel dieses Silizium als luftgekühlte, auf Inferenz optimierte Kraftmaschine, die auf den riesigen, unterversorgten Markt für Unternehmens-Rack-Server abzielt, denen die Infrastruktur für flüssigkeitsgekühlte thermische Dichten von mehreren Kilowatt pro GPU fehlt.
Die D-Serie ist effektiv ein Eingeständnis, dass der Weg zur Marktrelevanz über Zugänglichkeit und thermischen Pragmatismus führt und nicht über absolute Single-Die-Leistung. Indem Intel eine TDP von 350 W und traditionelle PCIe-Formfaktoren priorisiert, umwirbt das Unternehmen die große Masse der bestehenden und aktuellen KI-Infrastrukturumgebungen. Dies ist eine „Brot-und-Butter“-Strategie, die darauf abzielt, eine kohärente, skalierbare Lösung für Multi-Tenant-Inferenz, Robotik und Edge-lastige KI-Aufgaben bereitzustellen, bei denen Leistung pro Watt und betriebliche Einfachheit Vorrang vor dem maximalen Trainingsdurchsatz haben.
Zentrale architektonische & technologische Innovationen
Das Herzstück der D-Serie bildet die Xe3P-Architektur, eine spezialisierte Ableitung von Intels Grafikgrundlage, der die traditionellen Rasterisierungs- und Geometrie-Pipelines entzogen wurden. Dies ist keine GPU im herkömmlichen Sinne, sondern eine massiv parallele Rechenmaschine, die speziell für die datenintensive Natur der Inferenz entwickelt wurde. Der Fokus liegt hier auf einem hohen Durchsatz, was durch die Speicherbandbreite von 1,5 TB/s belegt wird, die entscheidend ist, um die Engpässe zu vermeiden, die beim Laden großer Parametermodelle in lokale Puffer während gleichzeitiger Inferenzsitzungen entstehen.
Intels Engagement für die „gemeinsame Xe-Softwaregrundlage“ ist der Dreh- und Angelpunkt für den Erfolg dieser Hardware. Historisch gesehen war die Achillesferse von Intels diskreten Beschleunigerbemühungen die Diskrepanz zwischen Siliziumfähigkeit und Software-Reife. Indem Intel die D-Serie in einem etablierten Software-Ökosystem verankert, das ihre integrierten und diskreten Mobil-/Desktop-Angebote durchdringt, versucht Intel, die Eintrittsbarriere für Entwickler zu senken. Das Ziel ist es, einen nahtlosen Übergang für Modelle zu ermöglichen, die für Xe-basierte mobile Plattformen optimiert wurden, um sie in großem Maßstab auf D-Serien-Racks bereitzustellen, wodurch effektiv ein einheitlicher KI-Bereitstellungspfad vom Edge bis zum Rechenzentrum geschaffen wird.
Empirische Spezifikationen & Benchmark-Matrix
| Spezifikation | Intel GPU D-Serie | Nvidia Rubin (geschätzt pro GPU) | Marktsegment |
|---|---|---|---|
| Architektur | Xe3P | Vera Rubin | Inferenz/Training |
| FP8 Peak-Leistung | 1,3 PFLOPS | 17,5 PFLOPS | Skalierung |
| Speicherbandbreite | 1,5 TB/s | N/A (HBM4) | Durchsatz |
| TDP | 350W | 1000W+ | Thermische Hülle |
| Kühlung | Luft | Flüssigkeit | Infrastruktur |
Thermik, Effizienz & Ergonomie in der Praxis
Indem Intel die GPU D-Serie auf 350 W begrenzt, hat das Unternehmen effektiv die größte Hürde für viele Unternehmenskunden umgangen: die Nachrüstung von Flüssigkeitskühlungen. Im modernen Rechenzentrum sind die Kosten für die Installation fortschrittlicher Kühlinfrastruktur für einen kleinen Cluster von KI-Servern oft unerschwinglich. Die D-Serie bietet eine „Drop-in“-Fähigkeit für bestehende luftgekühlte Rack-Umgebungen, sodass Unternehmen ihre Inferenzkapazität auf bis zu acht GPUs pro Knoten skalieren können, ohne eine massive Überholung ihrer Stromversorgungs- oder Kühlsysteme auszulösen.
Darüber hinaus adressiert die Integration von bis zu 480 GB LPDDR5X-Speicher die Nachfrage nach Unterstützung großer Parametermodelle bei kompakter Bauweise. Während LPDDR5X im Vergleich zu HBM3/4 etwas an absoluter Geschwindigkeit einbüßt, sind sein Effizienz- und Kostenprofil ideal für Inferenz mit langem Kontext und Multi-Tenant-Dienste. Dies stellt sicher, dass die D-Serie für Anwendungen mit langer Laufzeit und Latenzempfindlichkeit rentabel bleibt, bei denen das Ziel darin besteht, die Anzahl der gleichzeitigen Benutzeranfragen zu maximieren, anstatt ein massives Modell in Rekordzeit durch eine Trainingsepoche zu jagen.
Das endgültige Urteil
Intels GPU D-Serie ist ein kalkuliertes, realistisches Produkt, das dem aktuellen Stand der Branche entspricht: ein dringender Bedarf an effizienter, zugänglicher Inferenz-Hardware. Es ist kein „Nvidia-Killer“ im Sinne reiner Leistung, und das will es auch nicht sein. Stattdessen ist es ein wesentliches Puzzleteil für Unternehmen, die die extremen Anforderungen an die Flüssigkeitskühlung der aktuellen Flaggschiff-KI-Chips nicht erfüllen können oder wollen. Vorausgesetzt, Intels Treiber-Stack und Software-Ökosystem halten dem realen Einsatz stand, könnte die D-Serie der pragmatischste Beschleuniger der jüngsten Unternehmensgeschichte sein. Für Organisationen, die Skalierbarkeit bei der Inferenz und Betriebskosten priorisieren, ist die D-Serie als primärer Kandidat für die Bereitstellung wärmstens zu empfehlen.