Zusammenfassung & Marktpositionierung
Die Landschaft der KI-Beschleuniger veränderte sich dramatisch nach der strukturell einzigartigen 20-Milliarden-Dollar-Transaktion von Nvidia, die den bahnbrechenden LPU-Architekten (Language Processing Unit) Groq betraf. Anstatt eines traditionellen, vollständigen Unternehmenskaufs strukturierte Nvidia eine hybride Vereinbarung, die eine Lizenzgebühr von 17 Milliarden US-Dollar für das geistige Eigentum von Groq sowie einen dedizierten Aktienpool von 3 Milliarden US-Dollar für die rund 200 Ingenieure umfasste, die direkt in die Hardware-Abteilung von Nvidia wechselten. Dieses unkonventionelle Manöver, das von Regulierungsbehörden als „Reverse Acqui-hire“ bezeichnet wird, hat eine intensive Prüfung ausgelöst, die in einer geplanten Sammelklage gipfelte, die von den ehemaligen Groq-Ingenieuren Benjamin Serebrin und Joshua Rubin vor dem Delaware Court of Chancery eingereicht wurde. Die Kläger behaupten, dass der Vorstand bestimmte Risikokapitalgeber bevorzugt und die allgemeinen Aktionäre benachteiligt habe – eine Kontroverse, die durch aktive Untersuchungen des Justizministeriums und der Federal Trade Commission noch verschärft wird.
Aus Sicht der Marktpositionierung ermöglicht es die Vereinbarung Nvidia, deterministische Inferenztechnologie mit extrem niedriger Latenz direkt in seine High-End-Rechenzentrums-Bereitstellungsstrategien zu integrieren. Nvidias SEC-10-K-Einreichungen zeigen, dass etwa 14,4 Milliarden US-Dollar des Lizenzkapitals als Firmenwert verbucht wurden, der explizit an die spezialisierte Belegschaft und die zukunftsorientierte technologische Entwicklung gebunden ist, während nur 2,5 Milliarden US-Dollar direkt den grundlegenden Hardware-Designs zugerechnet wurden. In der Zwischenzeit hat sich die verbleibende Groq-Einheit aggressiv auf Cloud-basierte KI-Dienste verlagert, betreibt Rechenzentren und setzt ihre eigenen Technologien unter dem neu gebrandeten Nvidia-Groq-3-LPX-Framework ein. Dieses risikoreiche rechtliche und kommerzielle Manöver definiert neu, wie Billionen-Dollar-Unternehmen Ingenieurstalente akquirieren und traditionelle Kartellrechtsprüfungen umgehen, während sie gleichzeitig Silizium-Architekturen festigen, die speziell für die Dekodierungsphasen großer Sprachmodelle (LLMs) im massiven Maßstab entwickelt wurden.
Zentrale architektonische & technologische Innovationen
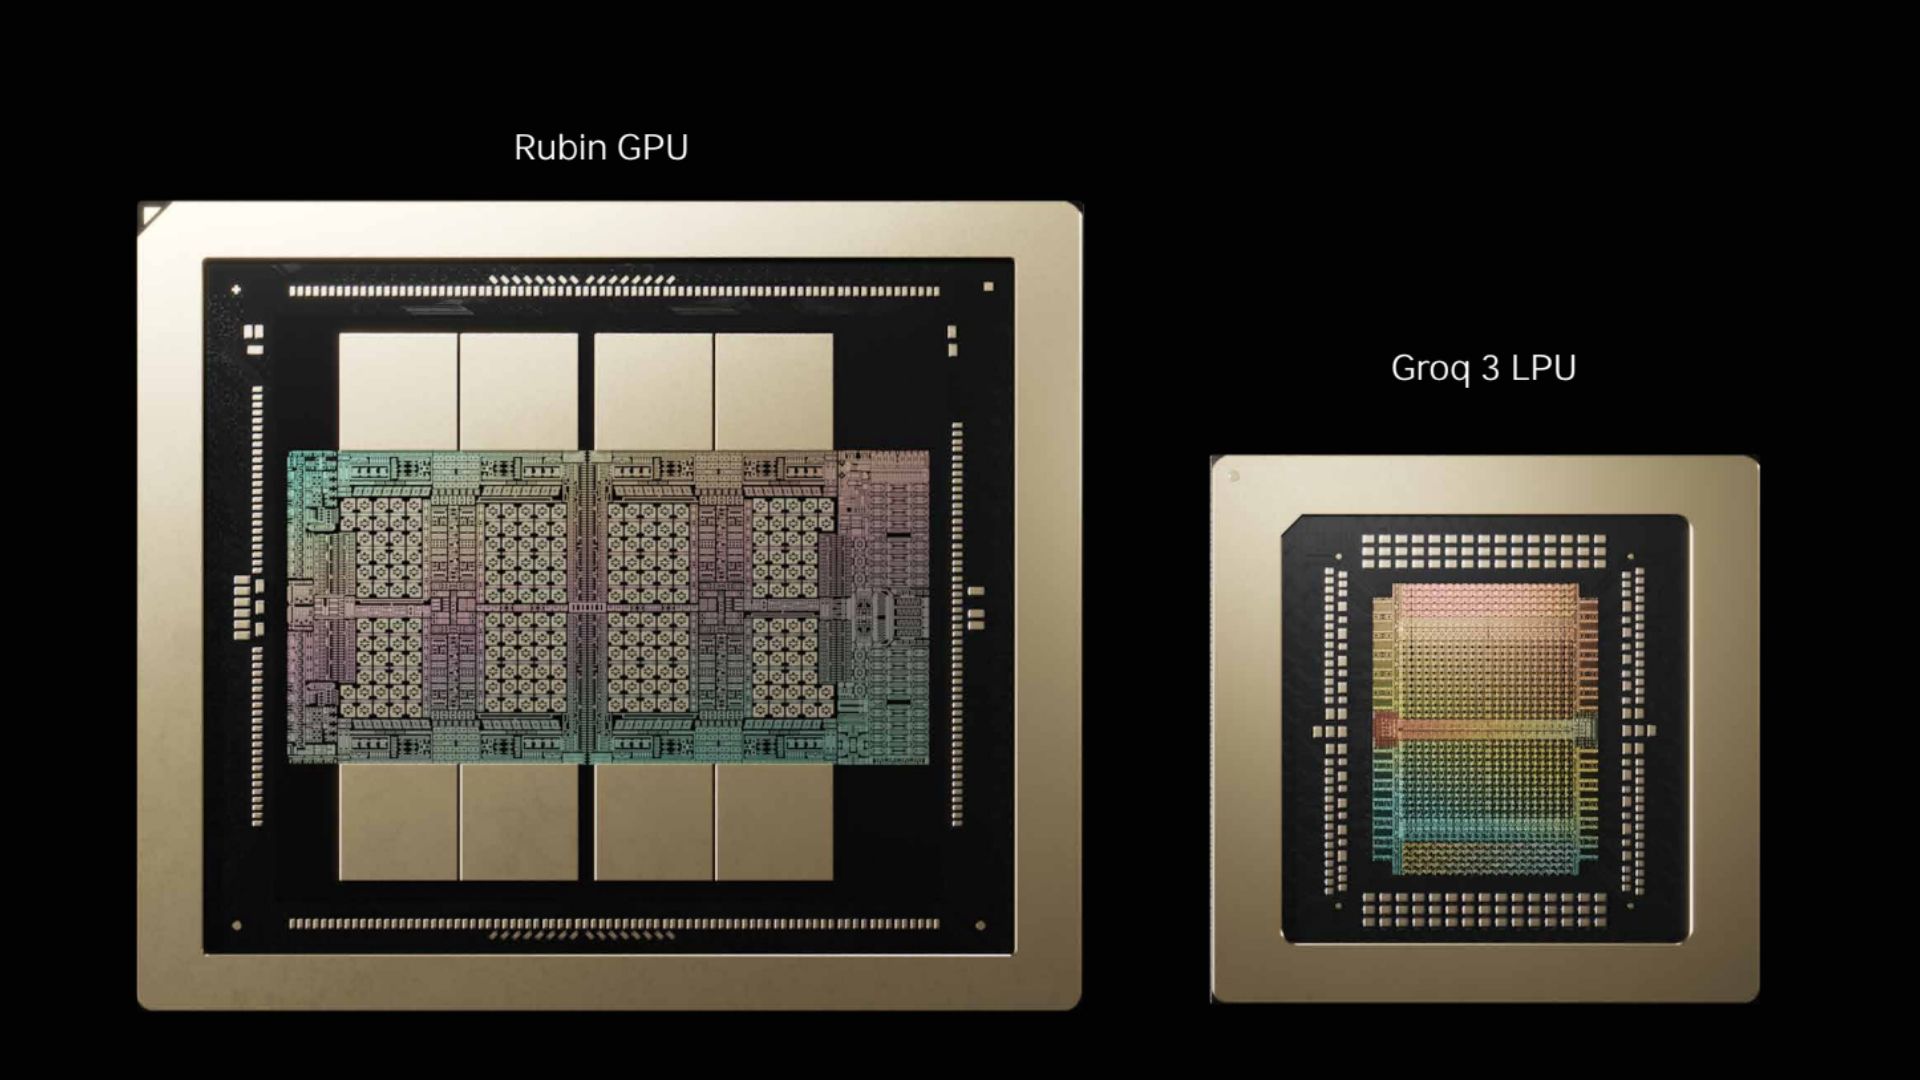
Auf Siliziumebene manifestiert sich das Ergebnis dieser Transaktion im Groq LP30, einer revolutionären Inferenz-Engine, die auf der fortschrittlichen 4nm-Prozesstechnologie (SF4X) von Samsung basiert. Im grundlegenden Gegensatz zu traditionellen GPU-Architekturen, die stark auf komplexe Caching-Hierarchien und dynamische Zeitplanung angewiesen sind, nutzt die Tensor-Streaming-Architektur von Groq ein softwaredefiniertes, deterministisches Ausführungsmodell. Jeder LP30-Die enthält erstaunliche 500 MB Hochgeschwindigkeits-SRAM direkt auf dem Chip, was eine massive aggregierte Speicherbandbreite von 150 TB/s pro Die ermöglicht. Diese Designphilosophie eliminiert den von-Neumann-Flaschenhals, der Off-Chip-HBM-Abrufzyklen innewohnt, und macht die LPU zu einem außergewöhnlich effizienten Dekodierungs-Co-Prozessor in Kombination mit Nvidias kommender Vera-Rubin-NVL72-Infrastruktur.
Bei der Skalierung dieses Siliziums auf Systemebene konsolidiert das Nvidia-Groq-3-LPX-Rack 256 einzelne LPUs zu einem einzigen dichten Rechenknoten. Diese kollektive Architektur liefert 128 GB ultraschnellen, verteilten On-Chip-SRAM, eine atemberaubende interne Verbindungsbandbreite von 40 PB/s und eine aggregierte Leistung von 315 FP8 PFLOPS. Durch die Funktion als spezialisierter Dekodierungs-Co-Prozessor entlastet die LPX-Architektur speicherintensive Token-Generierungsphasen von primären Tensor-Kernen, wodurch die Zeit bis zum ersten Token und der Token-Generierungsdurchsatz für massive generative KI-Workloads drastisch beschleunigt werden. Zukünftige Roadmap-Iterationen wie der LP35 mit nativem NVFP4-Support und der nachfolgende LP40, der für Feynman-Generationssysteme entwickelt wurde, signalisieren, dass Nvidia beabsichtigt, dieses deterministische Ausführungsmodell tief in seinem generationsübergreifenden Rechenzentrums-Stack zu institutionalisieren.
Empirische Spezifikationen & Benchmark-Matrix
| Architekturparameter | Groq LP30 / LPX Rack | Baseline GPU-Inferenzknoten (H100/B200) | Vorteil / Kompromiss |
|---|---|---|---|
| Prozessknoten | Samsung 4nm (SF4X) | TSMC 4N / 3nm Klasse | Höhere Transistordichte vs. ausgereiftes Foundry-Ökosystem |
| On-Chip-Speicher (SRAM) | 500 MB pro Die / 128 GB pro Rack | Begrenzter L2-Cache (~50 MB - 100 MB) | Massive deterministische Scratchpad-Kapazität |
| Off-Chip-Speicher | SRAM-zentriert (Keine HBM-Abhängigkeit) | HBM3e / HBM4 (Bis zu 8 TB/s pro GPU) | Eliminiert Off-Chip-Latenz-Nachteile bei Inferenz |
| Aggregierte Bandbreite | 150 TB/s (pro Die) / 40 PB/s (Rack) | ~8 TB/s pro Beschleunigerknoten | Beispielloser Token-Generierungsdurchsatz |
| Rechenleistung | 1,23 FP8 PFLOPS (einzelne LPU) | Variabler FP8 Tensor-Core-Durchsatz | Explizit für deterministische Dekodierungsphasen optimiert |
Thermik, Effizienz & Ergonomie in der Praxis
Die Integration von 256 LPUs neben massiven SRAM-Arrays in einem Standard-Server-Rack-Fußabdruck führt zu schwerwiegenden Problemen der thermischen Dichte. Im Gegensatz zu herkömmlichen GPU-Clustern, bei denen die Wärmeableitung von Hochleistungs-HBM-Stacks und massiven monolithischen Rechen-Dies dominiert wird, verteilt die Groq-LPX-Architektur die thermische Last auf zahlreiche kleinere, hochfrequente SRAM-lastige Dies, die auf Samsungs 4nm-Knoten basieren. Dieses verteilte thermische Profil erfordert eine maßgeschneiderte Flüssigkeitskühlung, um optimale Sperrschichttemperaturen aufrechtzuerhalten, insbesondere beim Betrieb innerhalb dichter 200+-MW-Rechenzentrums-Fußabdrücke, auf die Groq und seine Cloud-Partner derzeit skalieren.
Aus Effizienzperspektive führt das Weglassen von stromhungrigen Off-Chip-Speicherschnittstellen (wie Multi-Stack-HBM) zu erheblichen Effizienzgewinnen während der autoregressiven Token-Generierungsphase. Da aktive Arbeitssätze vollständig innerhalb der 128-GB-SRAM-Grenze eines 256-LPU-Racks verbleiben, sinkt der dynamische Stromverbrauch pro generiertem Token drastisch im Vergleich zu herkömmlichen Architekturen, die wiederholt Gewichte aus externem DRAM abrufen. Benchmarks aus der Praxis unterstreichen, dass diese deterministische Pipeline Tail-Latenzen minimiert und vorhersehbare operative SLAs für KI-Cloud-Anbieter wie Nebius und Dell-Integrationspartner gewährleistet, die Produktions-Inferenz-Cluster skalieren.
Das endgültige Urteil
Nvidias 20-Milliarden-Dollar-Groq-Transaktion ist ein Meisterkurs in der modernen Unternehmensakquisition. Sie umging erfolgreich Standard-Fusionsblockaden und sicherte sich gleichzeitig das branchenweit führende deterministische LPU-Talent sowie geistiges Eigentum. Architektonisch stellen die resultierende Groq-3-LPX-Plattform und das zugrunde liegende LP30-Silizium einen monumentalen Sprung in der Effizienz der autoregressiven Token-Generierung dar und beweisen, dass SRAM-zentrierte, softwaredefinierte Ausführungsmodelle eine dauerhafte und kritische Rolle bei KI-Bereitstellungen im Hyperscale-Bereich der nächsten Generation spielen. Der Schatten aktiver Untersuchungen durch das Justizministerium und ungelöster Aktionärsklagen in Delaware bringt jedoch eine anhaltende regulatorische Volatilität in den langfristigen kommerziellen Horizont der Hardware. Für Unternehmenskäufer und Cloud-Architekten ist die Hardware-Leistung unbestreitbar erstklassig; für den breiteren Halbleitermarkt schafft dieser Deal einen umstrittenen Präzedenzfall, der dauerhaft verändern wird, wie geistiges Eigentum und Elite-Ingenieurteams erworben werden.